Peter · 北京 · 云原生 / DevOps

效率研发基建 Agent 云端执行

  • 经验5 年云原生与 DevOps 全栈研发,覆盖分布式构建、Linux 底层调优与 AI 工程平台。
  • 专长CI/CD 平台、构建缓存、集群治理与源码级排障,贯通开发、交付和运行维护。
  • 开源AGSwitch 组织受管客户端 · AIGateway 多模型网关。
  • 云端CloudAgent:预热后 Claude 请求 4.449s;Pod 创建至就绪 5s,Agent 冷启动 9s。

滚动保留阅读位置 · 可从章节目录复制分享链接

个人核心优势

六条主线:把超大规模构建集群运维得稳定高效、把网络与流量变成可定位的观测面、把研发链路做成可复用平台、把线上状态全部收敛到 IaC、把硬件与带外管理纳入日常运维、把 Agent 能力做成可弹性伸缩的生产系统。

超大规模构建集群 · 深度排障

华为云云龙 DevOps 超大仓分布式编译(昇腾 / 鸿蒙):构建 CAS 800T,缓存命中 95%+ 时仍占 2 万核 / 40 TB,相当于节约 38 万核 CPU / 760 TB 内存;独立运维单集群 上千节点,Bazel 分布式编译集群资源消耗降低 70%。

深度排障:定位重复文件下载与重复构建并增加 fastpath,缩短构建时间 70%;QEMU 逐行 debug 内核启动;perf / strace 跨层定位。源码级经验横跨 K8s 与 OpenStack,覆盖分布式 CSI 快照与克隆、极速快照、COW 与 dentry / dcache。

网络与流量可观测

网络知识覆盖从单机网络堆栈到交换机:iptables / nftables、WireGuard、tcpdump、eBPF 与 K8s Calico 网络模型,能顺着内核协议栈、转发面到交换机逐层定位连通性与丢包问题。

自研流量可观测与流量镜像分析等 debug 组件,用于出口链路、跨集群互通与转发异常的现场定位与状态回读。

效率研发基建 · CI/CD 全栈

GitLab CE / Runner 治理与单 Job 部署契约(validate→build→publish→deploy→verify→cleanup),工具链版本由 versions.env 单点锁定。

基于 Bazel / BuildBarn / ccache 落地分布式增量构建缓存,优化 CMake / Maven 构建链路。

Agent 弹性计算

Agent 沙箱快照与快速恢复、容器化沙箱、任务编排与并发限流;把批量推理、异步队列、失败重试做成可调度能力。

自建 LLM 网关支撑 Claude Code / Desktop 等 Agent 客户端规模化接入,并持续跟踪模型用量与缓存命中;本机 Codex 的上下文窗口、压缩点和子代理并发按实际运行值校准,参数见下方配置记录。

SRE · IaC 全量纳管

线上全部由 IaC 表达:174 个注册组件(Terraform 26 / K8s 107 / Helm 3 / 主机 38),覆盖 2 个 CCE 集群、5 台 BCC、7 个 /24 子网、9 个 AppBLB、22 个安全组与 119 条规则、7 个 BOS 桶。

iac diff / apply --exact 逐组件回读,terraform plan / kubectl diff / helm template 三类判据给出 0 / 2 退出码——repo↔live 零漂移才算完成,线上不留未纳管资产。

硬件与带外管理

交换机侧做 VLAN 划分、链路聚合与端口镜像(镜像流量直接喂给自研流量分析组件),排障从 MAC 表、光模块一路查到链路误码。

服务器侧用 IPMI / Redfish 做带外管理:远程开关机与 KVM、传感器与 SEL 日志判读、BIOS / BMC 固件升级;硬盘与 RAID 故障同样从 SEL 与 dmesg 入手定位。

专业技能

横跨效率研发基建、超大规模构建集群调优、SRE / IaC、网络与硬件运维、AI 工程化平台。

编程语言Go(主力,标准库优先) · Python · TypeScript / React 19 · Shell · C
CI/CD 与 DevOpsGitLab CE / Runner · 单 Job 部署契约(validate→build→publish→deploy→verify→cleanup) · 灰度与回滚 · 质量门禁 · 自动化工具建设
系统与内核strace / perf 跨层定位 · overlayfs 与容器根文件系统 · dentry / dcache 路径优化 · COW 写时复制 · QEMU 逐行 debug 内核启动
网络与流量交换机(VLAN / 链路聚合 / 端口镜像) · 单机网络堆栈 · iptables / nftables · WireGuard · tcpdump · eBPF · K8s Calico 网络模型 · 自研流量可观测与镜像分析组件
SRE 与 IaCTerraform(BCC / VPC / CCE / BOS / AppBLB / EIP / DNS,26 个模块) · iac diff / apply --exact 逐组件漂移回读 · Kustomize / Helm · 主机侧 systemd + reconcile 脚本 · IPMI / Redfish 带外管理(KVM、SEL 日志、固件升级)
构建与打包分发BuildKit / BuildKitd 0.30.0 · registry 远程缓存 · 分布式增量构建缓存(Bazel / BuildBarn / ccache) · Dockerfile 分层与 cache mount · 镜像归档与不可变 tag · versions.env 单点锁定
容器与编排Kubernetes 1.34(CCE 双集群) · StatefulSet / 反亲和 / PDB · 蓝绿双槽与 preStop 优雅排空 · nftables 透明 REDIRECT · Helm / Kustomize
存储与快照分布式 CSI · CDS CSI(含 StorageClass 调优) · 极速快照 · COW 写时复制 · dentry / dcache 优化 · JuiceFS
云基础设施百度云 BCC / CCE / BOS / CDS / CCR / AppBLB / EIP · Terraform · VPC 七子网 · 阿里云 ECS + acme.sh DNS-01
缓存与制品Nexus 2-0(工具原生 mirror,唯一持久制品源) · Squid / go-proxy 三端口出口 · JuiceFS CE 1.3.0 S3 网关 · 15 字段访问日志
可观测性Prometheus 3.13.2 · Grafana 13.1.3 · Loki 3.7.6 · Alloy · Alertmanager · blackbox · 自研 Go exporter · 飞书告警卡片
AI / LLMnew-api 定制 fork · 三协议(OpenAI Chat / Responses / Anthropic) · DeepSeek / 智谱 GLM / 百度千帆多模型路由 · Claude 别名链式映射 · tiered_expr 分时计价 · LLM 缓存命中诊断
Agent 平台Agent 沙箱快照与快速恢复 · 容器化沙箱 · Skills/MCP 与 Prompt Template · 飞书群聊机器人 · Claude Code / Desktop / OpenCode
安全与凭据Logto OIDC(PKCE S256 + JWKS) · Passkey / WebAuthn · AES-GCM state.enc · Ed25519 签名自升级 · mTLS 内网域名

有趣探索

排障与折腾:根因往往在更深的一层,好玩的东西往往自己动手做。

QEMU 逐行 debug 内核启动

用 QEMU 单步跟踪引导链与内核初始化,定位内核启动失败的根因,并打通 debug 流量发送 链路。

这类问题没有现成答案,靠的是对启动流程、内存布局与硬件初始化顺序的完整理解。

libc / libc++ 段错误定位

崩溃栈落在 libc / libc++,根因却在上层软件的非法调用。顺着调用栈回溯到真正的调用方,核对参数约定与对象生命周期,最终从业务侧规避,而不是去改标准库。

难点在于:栈顶只是受害者,不是肇事者——定位必须穿透到真正的调用方。

私有云除零与硬件级故障

从 dmesg 里区分软件除零与硬件异常,确认是硬件问题后联合厂商复现故障、定位根因,最终通过升级 flash 固件解决。

软件日志只能给线索,硬件问题要和厂商一起收敛到可复现的最小现场。

为 NFS CSI Driver 增加快照与克隆

在 NFS CSI 驱动上补齐 VolumeSnapshot 与卷克隆能力,把原本缺失的存储特性接进 K8s 存储链路。

涉及 CSI 接口契约、external-snapshotter 协作与底层卷语义的一致性设计。

自研硬件小盒子

ESP32 蓝牙配网盒子:不用串口、不用改固件,手机端即可完成设备联网,把「设备怎么连上网」从工程操作变成普通人也能完成的动作。

AI 语音盒子:端侧拾音 + 云端大模型推理,把语音入口做成能摆在桌上的实体设备——和自建 LLM 网关是同一套思路。

WireGuard 跨城组网小盒子

把北京、武汉、长沙三地的设备组进同一内网:重编 ARM 内核启用 WireGuard 内核模块,单台成本约 50 元。

用来验证一件事:跨城组网不必依赖商业方案,内核能力用对了就够了。

工程理念

驱动我做基建的三条判断:速度是效率,可观测深度决定速度上限,治理标准靠工具强制而非人自觉。

构建速度即产品迭代速度

软件构建速度直接影响产品迭代效率:编译与 CI 的每一秒,都会乘以团队人数和每天的提交次数,最终体现在产品的迭代节奏上。

所以我把它当成可量化的工程指标来做——统一构建缓存、增量构建、部署契约与 SLA 门禁,而不是「差不多能跑就行」。

车灯效应

车灯照射的距离,决定了你能开多快:照得远才敢加速;只照亮眼前几米,就只能慢行。

工程系统同理——可观测的深度,决定团队能安全推进的速度上限。所以我先把回读、对账、回滚做扎实,再谈提速。

大型 monorepo 治理

日均 5,000+ PR 的仓库,靠人自觉守不住标准:统一构建、增量缓存、原子提交与可回滚发布,都必须由工具强制。

把这条当作默认工程约束——单 Job 部署契约、增量构建缓存、统一制品源,都是这条理念的落地形态。

业绩

重点不是「会调用模型」,而是把构建、发布、出口、缓存、观测与 Agent 做成可治理、可复用、能承载企业级研发流程的生产系统。

32 天,四条线并行:sreiac 仓库 2026-08-10 建立,到 09-11 的 32 天里并行推进四条线——代码仓从零建设(GitLab 生产割接 2026-08-13)、统一监控建设(Prometheus 规则 / Alertmanager / Grafana 看板 / 飞书告警)、sreiac 统一 IaC 多个项目、数据采集平台;其中 09-01 起的 11 天里产生 1,932 次提交(09-09 单日 350 次为峰值)。本条只给时间线与量级,下面每条成果都可以在仓库里逐项核对。

统一构建缓存与镜像体系

BuildKit registry 远程缓存跨 daemon 复用(空节点 export 后另一 daemon 免密 import 全层 CACHED);test / prod deploy job 实测 80s / 110s,单组件缓存约 381 MiB。

统一出口与三级缓存

Nexus 作唯一持久制品源(proxy store 抽样 6,213 blob / 1.55 GB),JuiceFS S3 网关压测单文件 716 MB/s、双文件 1.325 GB/s;自研 Go 出口数据面 + nftables 透明拦截 13 条路由。

自建 LLM 网关(三协议 · 三渠道)

同一入口暴露 OpenAI Chat / Responses / Anthropic 三协议,统一路由 DeepSeek、智谱 GLM、百度千帆,Claude 别名链式映射;百度渠道单日 6,486 请求 / 7.63 亿输入 token。

LLM 缓存失效定位

三家上游 × 两协议 × 每组 5 轮对照:去首轮加权命中率百度 24.999% vs zai 99.996% vs DeepSeek 99.675%;网关层 Claude 系统提示词中的缓存标记频繁变更,使缓存前缀无法稳定复用;修复后旧客户端由 25% 恢复至 95%。

可观测与告警栈

自建 Grafana 13.1.3(29 个看板 / 610 个面板,2026-09-09 回读)、Prometheus 3.13.2(41 个 scrape job、69 条告警 + 57 条 recording 规则)、Loki 日志;看板由脚本 diff 推送、变更零重启,告警经 Go webhook 机器人推送至飞书群。

数据采集平台

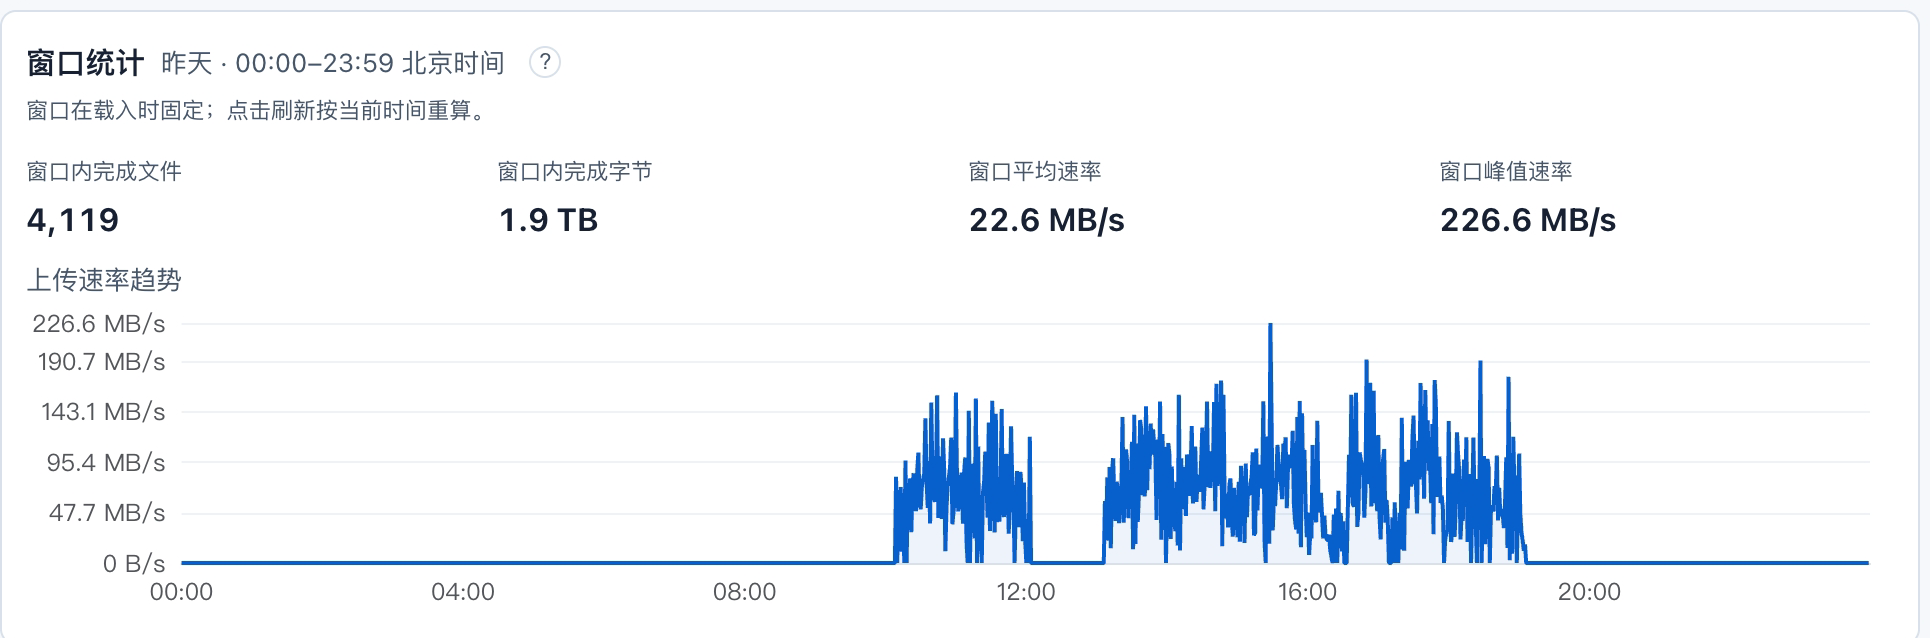
管理 9 台采集节点、每台 10 路并发,If-None-Match:* 幂等 + 64MiB 分片断点续传,单日采集窗口完成 1.9 TB mcap 数据(平均 22.6 MB/s、峰值 226.6 MB/s);Go 482 项测试 + race 437 项 + E2E 全绿,全部节点对象 HEAD 200 且长度逐字节相等。

独立主导项目(2026)

由我主导设计、定制与交付的项目。CloudAgent 展示云端执行与存储架构,AGSwitch 和 AIGateway 提供公开源码。基于开源项目的工作注明上游,历史业绩按各自采样日期保留。

CloudAgent · 云端 Agent 执行与持久化工作区 项目详情 ↗

计算与任务现场解耦。基于 Kubernetes Agent Sandbox 与云上自建 JuiceFS CSI 存储层,设计统一管理长期 / 临时 Sandbox、工作区、配额和调度的执行平台,通过 AIGateway 接入模型服务。

启动与预热实测(2026-09-21):预热实例的 Claude 请求端到端 4.449s;新 Pod 创建到 Ready 5s,Agent 冷启动 9s。预热数量可按请求负载配置,实例领取后自动补池,在响应速度与资源占用之间调整。

共享工具,独立工作区。常用 Agent CLI 以版本化只读运行时共享,多实例复用工具文件;任务数据进入独立可写工作区,减少重复安装和存储开销,提升 Sandbox 业务执行效率。

快速克隆与热数据加速。JuiceFS 通过元数据克隆复用已有对象块,修改采用 ROW(写时重定向),避免启动任务前复制整个工作区;节点缓存加速热数据读取。

按需存储与长期保存。S3 兼容对象存储承载持久文件,减少为每个 Sandbox 预购固定容量云盘产生的闲置成本。配合元数据备份,长期保留源码、日志、产物与任务文件,并通过克隆恢复工作现场。

查看完整架构设计、克隆流程与项目价值 ↗

AGSwitch · 组织级 AI 工具配置管理 项目详情 ↗

基于 cc-switch 二次开发,把个人多工具配置切换扩展为组织受管接入。通过兼容网关登录与浏览器设备授权,获取组织模型和配置,统一写入成员使用的 AI 工具。

客户端适配:Claude Code、Codex CLI、Gemini CLI、OpenCode、Hermes;增加 WorkBuddy 模型、渠道与配置管理。支持配置预览、备份恢复及用户配置云归档,减少手工配置与恢复成本。

职责边界:客户端负责配置落地,组织成员权限、集中计费、请求日志与审计由兼容网关提供;设备授权等扩展需要网关配合。公开仓库提供源码,安装包及自动更新以实际 Release 为准。

开源:github.com/peterplaykkk/agswitch ↗ · MIT · React / TypeScript / Tauri 2 / Rust。

AIGateway · 多模型 API 网关与组织接入 项目详情 ↗

2026.09 开源:基于 QuantumNous / New API 的增强发行版,保留上游归属与 AGPLv3 许可证,以脱敏源码快照发布。github.com/peterplaykkk/aigateway ↗。

公开版本增强:补齐更多上游的 OpenAI Responses 兼容,规范化工具调用与推理内容;按用户和模型分析请求趋势、峰值 RPM、Token 吞吐、缓存命中、延迟、费用与最终上游归因。增强动态阶梯计费、配额计算保护,以及设备授权、会话上限管理和用户配置归档 API。

以下为该网关在组织内的接入实践。公开源码不附带组织服务、生产配置或凭据。

自建 LLM 网关(内部域名 ai-gateway) — 一个入口同时暴露 OpenAI Chat Completions / Responses / Anthropic Messages 三套协议,统一路由 DeepSeek 官方与百度千帆(智谱 GLM 渠道已于 2026-09-10 下线)。Claude 别名经 model_mapping 链式回落,客户端无需改代码即可切换上游。

接入体验:飞书身份直接登录(Logto OIDC broker → 飞书企业连接器,Authorization Code + PKCE S256 + JWKS 验签),首次登录即 JIT 建号并自动开通内部月度订阅($68/月,每月 1 日重置)——员工不用自己开账号、不用垫钱报销、不用手抄 API Key。渠道密钥的明文读取额外要求 Passkey/2FA 安全证明。

客户端矩阵:Claude Desktop(3P 免登录模式)、Claude Code CLI、OpenCode、WorkBuddy 均已写成可直接照做的接入教程并沉淀到飞书 Wiki;网关前端内置 cc-switch 一键导入深链(ccswitch://v1/import?),点一下就把网关模型与密钥写进本机客户端。

Pi CLI 接入:为 @earendil-works/pi-coding-agent 0.85.1 增加自定义 provider(走 openai-completions 适配器),把网关模型接进 Pi。首次请求返回 HTTP 400——网关拒收 developer 角色、只接受 system,据此补上 supportsDeveloperRole: false,并一并处理 DeepSeek 的 thinkingFormat 与 reasoning_content 回放约定;凭据只在请求时从受保护的本地文件读取,不落进 Pi 配置。最小请求验证通过后,再用一次 bash 工具调用跑通「精确求 S = 1! + 2! + … + 100!」的完整工具链路。

面向公司文员与研发同等开放:装好客户端 → 飞书扫码登录 → 直接可用的 DS Flash / GLM / 新模型抢先体验。原先「每人自己买会员、自己垫钱、自己配置」的三件事被一次性消掉。

② new-api 深度定制(自研 fork) 项目详情 ↗

上游 QuantumNous/new-api 已 vendor 进仓库(普通目录,非 submodule),当前版本 v1.0.0-rc.22-sre.77。83 个提交全部由我本人编写,没有一条来自上游。定制方向是把一个「能用」的网关改造成可对账、可灰度的生产系统:

自研 pkg/billingexpr 分时计价表达式引擎(北京时间高峰 09:00–12:00 / 14:00–18:00 与低峰两档,低峰价恰为高峰一半;日志 quota 与表达式复算逐笔相等);自研 Prometheus 导出器、Qianfan 成本导出器与 sqlite-to-postgres 迁移工具;把 relaykit 拆成可独立构建的子模块;Dockerfile.sre 实现零网络离线构建(基础镜像全部按 CCR VPC digest 锁定)。发布侧是蓝绿双槽 + 10 秒级连续探针 + 完整回滚演练。

③ agmem · 自建知识提取与多层索引缓存 项目详情 ↗

面向研发问答与 Agent 的共享知识服务,接收 Wiki 增量同步、人工推送和知识提取结果。以异步清洗、embedding、Qdrant 索引和版本门控连接知识写入与检索。

本地与云端分别判定缓存:agmemd 先读取云端知识版本,再用本地 ONNX 向量在同目录缓存中比较余弦相似度;默认严格 >0.8 且版本一致才命中。未命中调用 agmemserv,由服务端依次判断精确缓存、embedding 后的语义缓存,再进入 Qdrant dense + BM25 混合检索与结果折叠。

新增、更新与失效:普通入库做批内和库内原文去重;Wiki 比较编辑时间,换版路径保留未变分段,新版入队后清理旧版。清洗任务完成条目 embedding 与 upsert 后更新知识版本,推动查询缓存失效。历史验收样本中缓存命中耗时约 0.09s,云端检索约 1.4s。查看本地比较与云端更新完整架构 ↗

④ 研发 FAQ 助手 项目详情 ↗

claude-ask-server + navigation 门户(内部服务导航门户):面向研发的问答助手,回答基于真实信息——只读克隆的 sreiac / datainfra 代码库、只读 kubeconfig(kci / kdi)、经 lark-cli 读取的飞书文档与 Wiki、以及上面的 agmem 知识库。

把内部流程做成 FAQ 直接命中:研发最高频的 12 类流程被固化成内置知识,命中即作答、不必先搜仓库——GitLab 提交代码 / 配置网关 DS Token / 发布 Skills / 发布 jar、npm 到 Nexus / 配置代码拉取权限 / 提交 merge request / 飞书机器人配置 / 代码开发规范 / 新建服务流程 / 统一出口代理 / 开发任务流程 / lark-cli 用法。只有追问「某个文件/命令当前的准确值」时才回读 1–2 次。

答案本身就是可执行的结构:回答固定三段——① 编号的具体步骤(可直接照做);② 代码块包裹的可复制命令(路径与命令准确);③ 验收点(怎么确认做成了),并注明来源。命令一律用代码块给出,给不出准确值时明说还需要补充什么信息。

安全边界是「默认拒绝」,但拦的是执行、不是回答:后端 bash 工具要求命令满足结构约束(无 ; | > < 反引号 $( ${ 与换行)并命中只读动词白名单,.store / .env / .kube / token / 私钥路径直接拦截,工作目录外路径一律拒绝——所以它会告诉你该敲哪条命令,但不会替你去执行变更。服务常驻 5 个预热 agent 池,SSE 流式输出并在前端逐条展示工具调用与来源,使用独立计费账号,跑在一台独立 BCC 上并纳入 Terraform 管理。

⑤ 数据采集平台(systemd + collect-agent) 项目详情 ↗

9 台采集节点(piper / arx5 机械臂),每节点 10 路并发。节点侧是一个 systemd 常驻的 bot-collection-agent(Restart=always、MemoryMax=512M,并申请内核文件租约能力以防写入中途被截断),业务模式下每分钟扫描目录。

按任务类型自动路由上报:ARX5 站点的 station.json 定义 instruction → 对象前缀 权威映射,Piper 走固定路径;pathLayout 区分 episode 与 task 两种目录形态。每条任务会把命中分支(如 station-route:uniqlo / dir-alias:uniqlo / piper)与完整目标路径随任务一起上报,出问题能直接定位到规则。

上传走 ≥64 MiB 分片(单文件上限 625 GiB / 10,000 分片),重启后按 ListParts 校验并只补未确认分片,写入一律带 If-None-Match: * 保证幂等(并发撞上必须 412 并保留原对象),自升级包用独立 Ed25519 密钥签名。

不规范数据告警:合规判定为「相对 key 至少 4 段非空目录,且第 2 段匹配日期」,违规被归为 5 类原因(路径不可路由 / 缺日期段 / 缺任务层 / 缺 episode 层 / 未知类别)。不合规文件不会被静默丢弃——它们仍会上传到 _violation/ 兜底命名空间,节点心跳同时上报 skippedByReason 分布,规则是禁止静默。首轮全量体检的违规率是 168 / 8.4%。

⑥ JumpServer 跳板机定制 · 接入 SSO 项目详情 ↗

把开源 JumpServer CE 改造成服从公司统一身份的工作站跳板:9 个上游仓库快照、4,595 个受控文件,按不可变 tag 锁定为基线;29 个新增文件 + 20 个修改文件共 49 项全部登记 SHA-256,校验脚本会重建上游清单并逐文件比对——任何未登记的差异、缺失、权限位变更都会让校验失败。

定制核心是严格 OIDC + 飞书邮箱身份:以 Logto 作为 OIDC broker 走飞书登录,要求 email_verified 为真,并把登录授权到 JumpServer 自己的账号表(规范化邮箱必须唯一命中一个启用中的非服务账号,首次登录绑定飞书 userId)。所有异常路径一律 fail-closed——配置不全、token 未签名、issuer/audience/JWKS 不符、邮箱缺失或歧义、账号停用、飞书身份与绑定不一致,全部拒绝,且只返回同一条不含细节的双语提示,内部仅记录结构化原因码。本地密码登录只保留给 admin 超管,写操作强制实时 MFA;移除账号时先禁用主体再撤销会话、API 凭据与终端会话,顺序不允许颠倒。

⑦ sreiac · 统一 IaC 与零漂移契约 项目详情 ↗

把整个基础设施收进一个仓库、一个入口:231 个注册组件(Terraform 26 / Kubernetes 149 / Helm 3 / 主机 53),统一由 scripts/iac 的 list / diff / plan / apply / gate 驱动,--exact 精确匹配单个组件、避免前缀展开误伤兄弟环境。

每个组件类型都有明确的 0-diff 判据:Terraform 用 plan -detailed-exitcode(0 干净 / 2 漂移 / 1 出错)、Kubernetes 用 kubectl diff、Helm 用 helm template | kubectl diff、主机侧走注册过的 reconcile 脚本。apply 默认只读,必须显式 --yes 才写入。三层门禁(pre-commit / pre-push / CI job)保证「线上 = 代码」不是靠自觉。

⑧ 分享与赋能 · skillshub / Agent 接入教程 项目详情 ↗

把个人踩过的坑变成团队资产:skillshub 是内部 Agent 技能注册中心,飞书企业身份经 Logto 登录,公共技能默认匿名安装(curl -fsSL …/skills-cli | sh -s -- install 用户/技能),发布者走登录后签发的读写令牌。

面向 IT 与办公同事写了 4 篇可直接照做的接入教程(OpenCode / Claude CLI / Claude App / WorkBuddy),沉淀在飞书 Wiki 的 Agent 目录下,覆盖 Base URL、模型声明、密钥隔离(chmod 600 的独立 env 文件)与验证步骤。

将真实操作过程整理为可执行步骤,并补齐配置位置、权限边界与成功判据,让团队成员能按统一入口完成接入和验证。
核心项目

以下项目聚焦同一件事:把复杂工程系统跑起来,并让它长期变好。

Buildfarm · 高速分布式编译与测试 项目详情 ↗

轻舟智航 · Bazel / Buildfarm · Remote Execution API · AC / CAS

负责上千节点日常保障与集群研发优化,规模 2 万核 / 40 TB 内存 / 300 TB 存储,构建缓存 95%+ 命中;通过调度、缓存与远程执行优化提升 C++、Go、JavaScript、Rust 编译与测试效率。

详情包含 Buildfarm 架构,以及 Codex 公开源码中的测试目标 cksum 分片和测试用例 FNV-1a 分片。Codex 使用 BuildBuddy 后端,同属 Bazel / REAPI 技术体系。

车企合规云与 CI / 构建系统(从 0 到 1) 项目详情 ↗

合规云 · CI/CD · 构建系统 · 仿真测试版本发布

服务奇瑞、吉利、理想等多家头部车企:从零建设合规云与 CI + 构建系统,支撑每天 上千个仿真测试版本 发布。

交付获甲方高度认可,并收到甲方 offer。

超大仓库分布式编译加速(昇腾 / 鸿蒙) 项目详情 ↗

华为云 · 云龙 DevOps · Bazel · BuildBarn · CAS · fastpath

服务 昇腾、鸿蒙 两个超大仓库源码构建:构建 CAS 缓存 800T,缓存命中 95%+ 时仍占用 2 万核 CPU / 40 TB 内存,相当于节约 38 万核 CPU / 760 TB 内存。

定位重复文件下载与重复构建问题并增加 fastpath 快速路径,缩短构建时间 70%;助力团队获得总裁嘉奖令。

统一构建缓存与镜像体系 项目详情 ↗

BuildKit 0.30.0 · GitLab CI · CCR registry cache · cache mount

2026-08-25 全链路验证通过并上线 prod:空节点 export 后另一 daemon 免密 import 全层 CACHED,实现跨 daemon 构建缓存复用。

test / prod deploy job 实测 80s / 110s(SLA ≤300s),单组件单 tag 缓存约 381 MiB;工具链版本由 versions.env 单点锁定。

分布式增量构建缓存 项目详情 ↗

Bazel · BuildBarn · ccache · BuildKit registry cache

华为 CloudBuild 时期基于 Bazel / BuildBarn / ccache 做分布式增量构建缓存,优化 CMake / Maven 构建链路;现网延续同一思路做 BuildKit registry 远程缓存跨 daemon 复用。

两条链路共同点:把「哪些产物可以复用」判断清楚,再把缓存做成可跨节点、可回读、可回滚的一等公民。

统一出口与三级缓存架构 项目详情 ↗

Go stdlib · nftables · Squid 三端口 · Nexus · JuiceFS CE 1.3.0

自研 Go 统一出口数据面承载 4 个代理口与 13 条透明出口路由;出口由 Squid 五入口重设计为三端口,3129/3127 退役。

Nexus 作唯一持久制品源(proxy store 抽样 6,213 blob / 1.55 GB),JuiceFS S3 网关压测单文件 716 MB/s、双文件 1.325 GB/s。

自建 LLM 网关(new-api 定制 fork) 项目详情 ↗

Go · React 19 · PostgreSQL · tiered_expr · Logto OIDC + Passkey

同一入口暴露 OpenAI Chat / Responses / Anthropic 三协议,统一路由 DeepSeek、智谱 GLM、百度千帆,支持 Claude 别名链式映射。

百度渠道单日承载 6,486 请求 / 7.63 亿输入 token;HA 迁移 600 秒探针 513/513 成功零中断,常规蓝绿切换零 502/503/504。

LLM 缓存失效定位与供应商级排查 项目详情 ↗

固定 IP 直连 · body SHA256 比对 · token 加权口径 · 双协议矩阵

三家上游 × 两协议 × 每组 5 轮对照:百度去首轮加权 24.999%(OpenAI)/ 24.949%(Anthropic),对比 zai 99.996% / 99.797%、DeepSeek 99.675% / 99.824%。

定位根因:网关层 Claude 系统提示词中的缓存标记频繁变更,使缓存前缀无法稳定复用;修复后旧客户端命中率由 25% 恢复至 95%。

可观测与告警栈 项目详情 ↗

Prometheus 3.13.2 · Grafana 13.1.3 · Loki 3.7.6 · Alloy · 飞书告警

29 个看板 / 610 个面板、41 个 scrape job、69 条告警 + 57 条 recording 规则,看板目录由脚本推送、变更零重启。

告警经 Go webhook 机器人推送到飞书群「sre告警」,critical 抑制同维度 warning,每日 02:00 投递统一巡检卡片。

数据采集平台(bot-gateway-collection) 项目详情 ↗

Go agent · BOS S3 分片上传 · Ed25519 自升级 · Kubernetes

管理 9 台采集节点,每台 10 路并发,上传以 If-None-Match:* 保证幂等,≥64MiB 文件按 64MiB 分片断点续传;单日采集窗口完成 1.9 TB mcap 数据(平均 22.6 MB/s、峰值 226.6 MB/s)。

验收覆盖 Go 482 项测试 + race 437 项 + PW E2E 18/18 + API E2E 8/8;机队逐台抽验(verify-fleet-objects.py,2026-09-08)对象 BOS HEAD 200 且 Content-Length 与任务 sizeBytes 逐字节相等。

云原生双集群 IaC(sreiac) 项目详情 ↗

Terraform · CCE Kubernetes 1.34 · VPC-ENI · CDS CSI · scripts/iac

VPC 内 7 个 /24 子网跨 4 可用区,ci-01 集群 16/16 节点 Ready,BuildKit 缓存 PVC 200Gi Bound/Retain。

以 iac diff 作为 repo↔live 零差异的全局底线,盘点并归组 115 项 unassigned 云资源(BCC 21 / CDS 66 / EIP 6 / AppBLB 23 / BOS 8)。

GitLab CI/CD 平台与 Runner 治理 项目详情 ↗

GitLab CE · GitLab Runner · BuildKitd · 单 Job 部署契约 · 质量门禁

单仓流水线 409 行 / 17 个 job,deploy 契约在单 Job 内完成 validate→build→publish→deploy→verify→cleanup。

Deploy Runner 收敛为单一 #3(并发 5)并下线 #1,跨环境无状态复用释放 2 台 BCC;GitLab 监控首屏热门请求 458.79K→909.14、P95 1.82s→469.50ms。

疑难问题定位

一次「大量请求下 GLM 偶发缓存命中偏低」的定位:从客户端、网关、出口逐层排除,直连源站复现,三家上游 × 两协议对照,最后把可复现的证据交到上游厂商手里。

现象:概率性的命中归零

网关按渠道统计时,百度千帆渠道的 glm-5.3-flash 缓存命中明显低于其他渠道(见 AI 消耗量:单日百度渠道 70.3%,DeepSeek 主力模型 98.3%)。

真正的特征要在受控复现里才看得清——高命中之后,下一笔可能直接归零,不是缓慢衰减,也不是首轮冷启动。

方法:把变量收敛到只剩上游

Mac 经 en0 直连源站固定 IP(--resolve 写死,逐笔断言 remote_ip),剥离代理环境变量并 --noproxy '*':25 次请求全部 HTTP 200、TLS 校验 0、HTTP CONNECT 0 次。

固定请求体、逐笔比对 body SHA256;命中率按 缓存读取 token / 输入总量 加权——不取每笔百分比的简单平均,也不只筛出有缓存的请求。

结论:上游侧可独立复现

同一份请求体、同一条链路,DeepSeek 与 zai 在首轮冷启动后连续四次稳定高命中,百度侧则多次返回零缓存——不经过 new-api 与统一出口即可复现。

网关层 Claude 系统提示词中的缓存标记频繁变更,使缓存前缀无法稳定复用;修复后旧客户端命中率由 25% 恢复至 95%。

接口百度 GLM-5.3-Flashzai 官方 GLM-5.3-FlashDeepSeek 当前渠道
OpenAI 协议24.999%99.996%99.675%
Anthropic 协议(统一合法 user_id)24.949%99.797%99.824%

口径:去首轮冷启动后四次的 token 加权命中率。百度与 zai 同协议的请求体连原始字节都完全一致(同一 SHA256),DeepSeek 仅 model 字段不同——差异不能归因于客户端改写或提示词变化。

多轮复现(2026-09-08):直连源站 + 五轮追加历史,6 组 × 5 轮共 30 请求全部 HTTP 200。baidu-openai 组第 2 轮 99.765% 命中之后,第 3 轮直接归零,该组第 2–5 轮加权被拉低到 74.743%;其余五组第 2–5 轮加权 99.501%–99.713%。miss 是概率性的——本轮 6 组中仅 1 组出现。

组别第 1→5 轮缓存率(%)第 2–5 轮加权
baidu-openai0 / 99.765 / 0 / 99.473 / 99.66174.743%
baidu-anthropic0 / 99.759 / 99.613 / 99.802 / 99.65699.708%
ds-openai0 / 99.747 / 99.587 / 99.427 / 99.26799.507%
ds-anthropic0 / 99.742 / 99.582 / 99.421 / 99.26299.501%
zai-openai0 / 99.765 / 99.619 / 99.807 / 99.66199.713%
zai-anthropic0 / 99.759 / 99.613 / 99.802 / 99.65699.708%
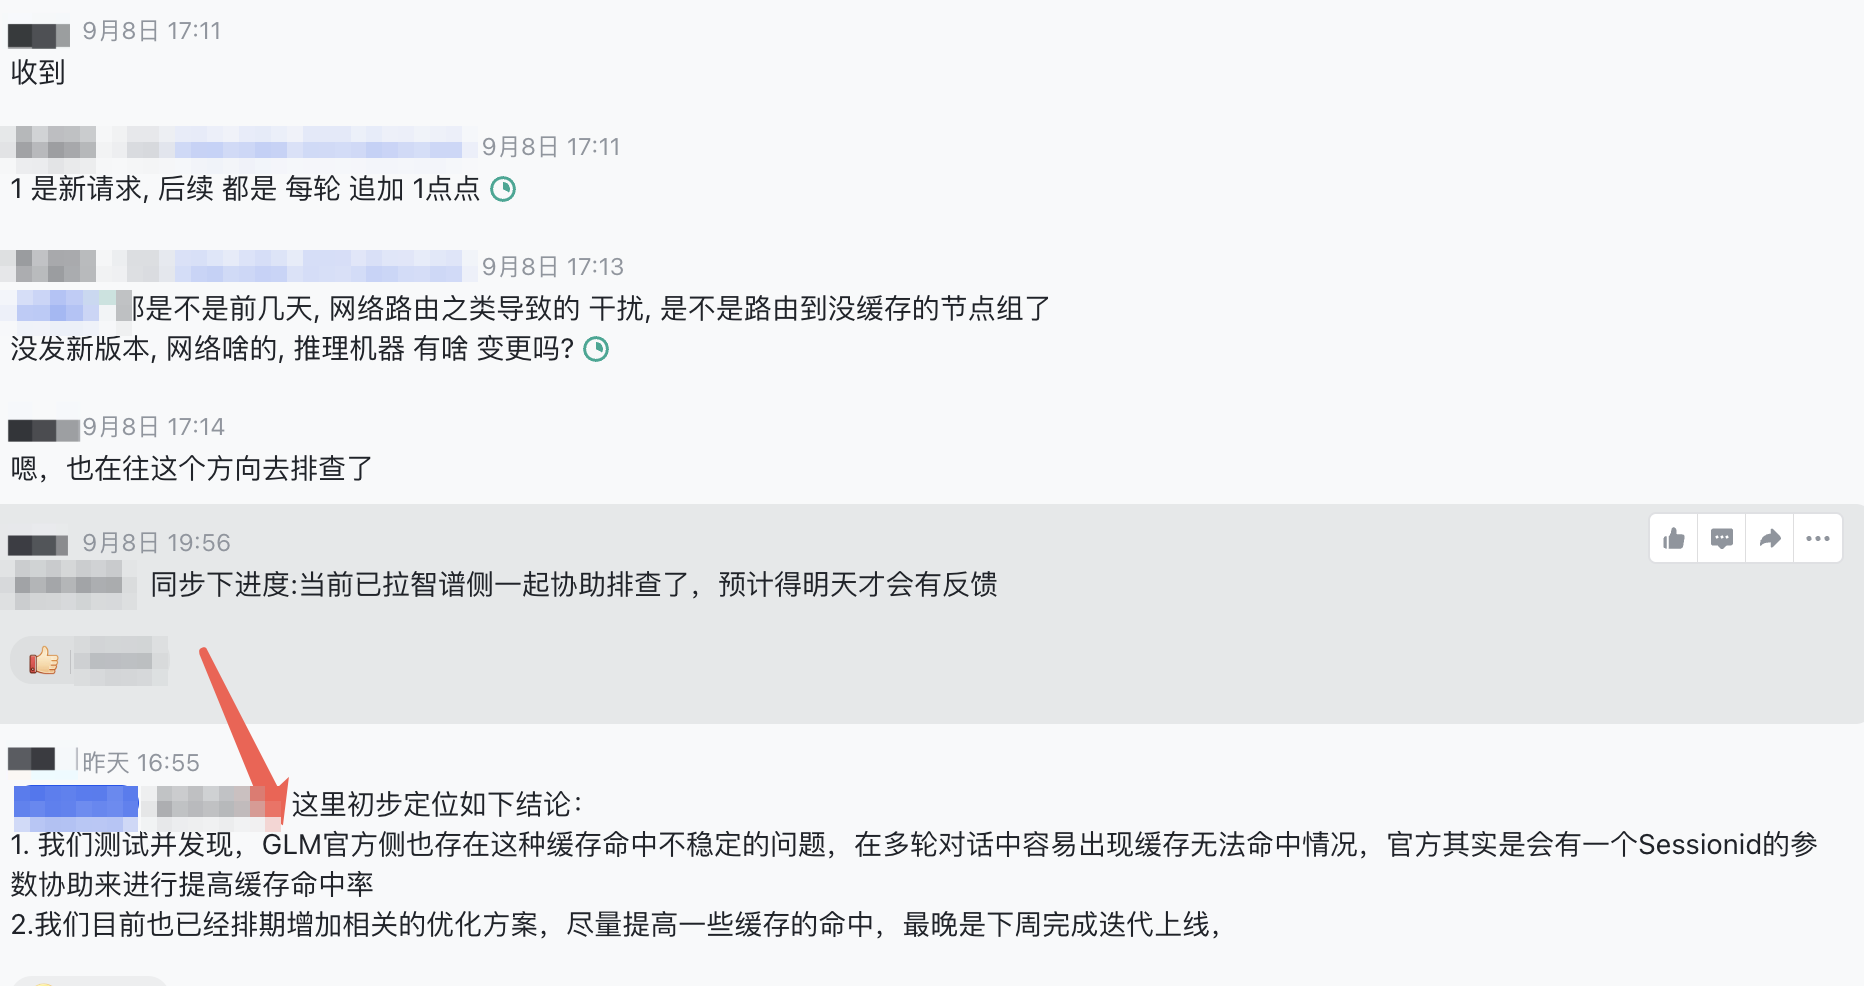
上游厂商在飞书群里的初步定位回复:这里初步定位如下结论:1. 我们测试并发现,GLM 官方侧也存在这种缓存命中不稳定的问题,在多轮对话中容易出现缓存无法命中情况,官方其实是会有一个 Sessionid 的参数协助用来提高缓存命中率;2. 我们目前也已经排期增加相关的优化方案,尽量提高一些缓存的命中,最晚是下周完成迭代上线
反馈上游后的回复:厂商测试后确认「GLM 官方侧也存在这种缓存命中不稳定的问题,在多轮对话中容易出现缓存无法命中」,并说明官方有 Sessionid 参数用于协助提高缓存命中率,相关优化已排期。截图中的账号与凭据信息已裁除,人名、@提及与链接已打码。

上游可用性故障识别与加固

识别

网关按渠道统计的错误率与端到端探针把上游异常单独暴露出来:DeepSeek 官方渠道间歇性返回 503 Server Overloaded,同期智谱渠道出现账号级 1302 限流。这类抖动在客户端侧只表现为「偶尔很慢/偶尔失败」,只有把渠道维度拆开才看得见。

加固

把重试设为 3 次,只对 5xx 与网络错误生效,同时把 auto_ban 置 0——否则一次上游 503 风暴会把整条渠道自动禁用,故障从「部分请求失败」升级为「整渠道不可用」。429 单独走 1s / 2s / 4s 有上限退避,并在客户端取消时停止等待。

兜底

余额维度另有 DeepSeekBalanceLow(<500 CNY)与 DeepSeekBalanceCritical(<100 CNY)两级告警及余额查询失联告警;发布侧走蓝绿双槽 + 10 秒级连续探针 + 完整回滚演练,保证加固动作本身不制造故障。

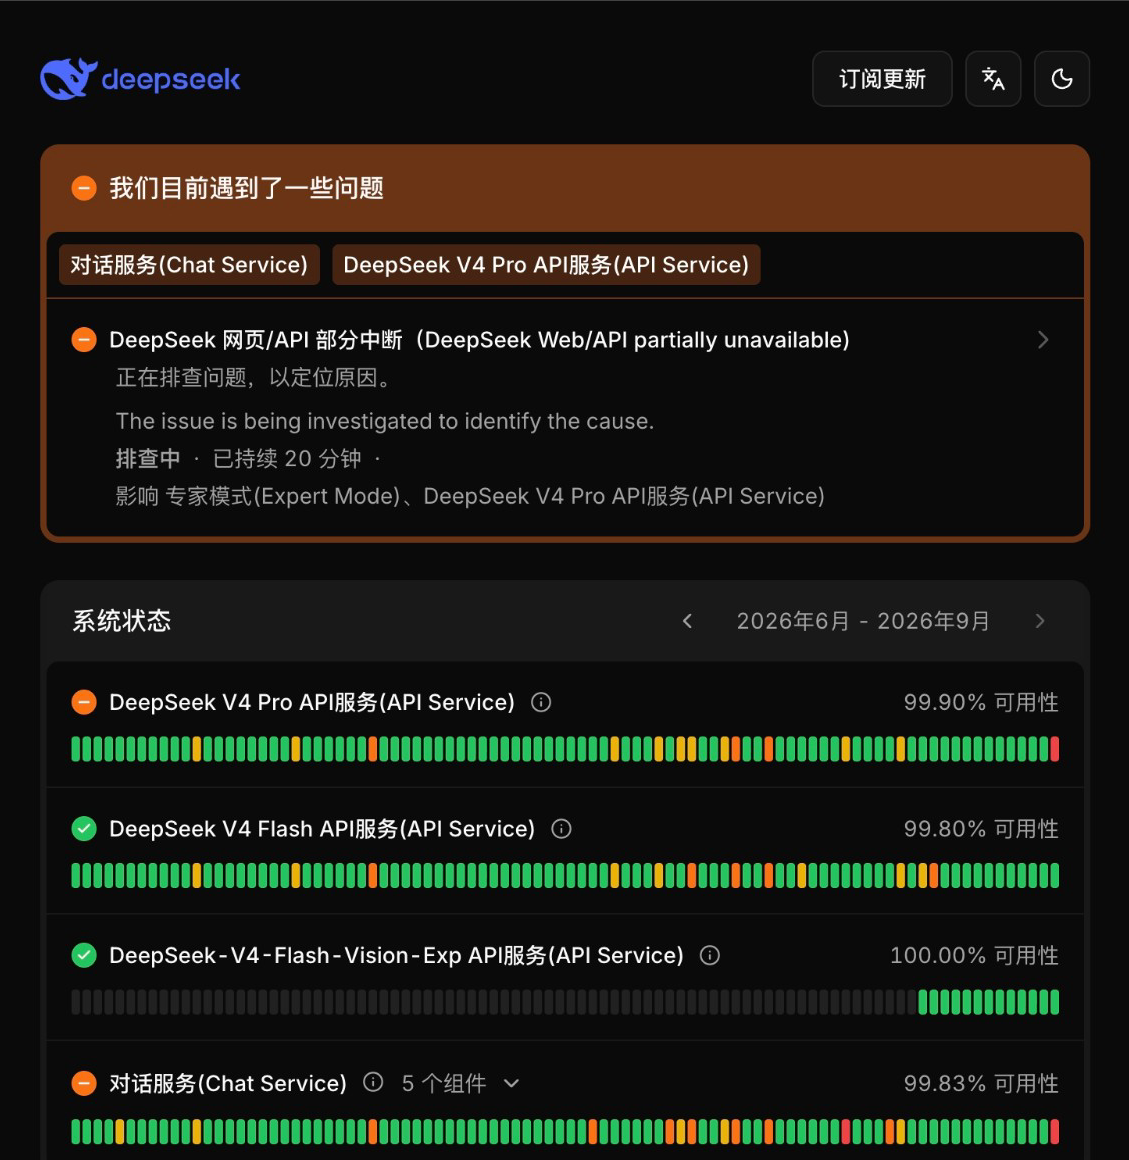
DeepSeek 官方状态页:DeepSeek 网页/API 部分中断,正在排查问题,已持续 20 分钟,影响专家模式与 DeepSeek V4 Pro API 服务;系统状态显示 2026 年 6 月至 9 月区间内 V4 Pro API 可用性 99.90%、V4 Flash API 99.80%、Flash-Vision-Exp 100.00%、对话服务 99.83%
上游事件留证:DeepSeek 官方状态页(2026-09-02 观测;图片为状态页原件,日期取自当日留档)——「网页/API 部分中断,排查中,已持续 20 分钟」,受影响范围包含专家模式与 V4 Pro API 服务;同期系统状态页显示 V4 Pro API 区间可用性 99.90%、对话服务 99.83%,绿条中密集的黄/橙/红即为抖动点。这正是网关需要做渠道级错误率观测与重试加固的直接依据。截图已裁除浏览器界面。

口径:以上是网关侧观测到的上游抖动与据此做的加固,不是对上游整体 SLA 的评价——状态页给出的区间可用性仍在 99.8% 以上,「间歇 503」与「长期不可用」是两回事。

边界:以上是单账号、约 45 秒时间窗的小样本复现,不是长期 SLA;请求体不含 system / tools / metadata,不直接外推到真实 agent 负载。测试只读取既有渠道认证、用完即删,未改动生产配置、未轮换凭据。

作品展示

最新 Agent 接入与云端执行架构置前;其后保留服务导航、监控看板、采集链路与研发 FAQ 助手的真实界面。架构图明确区分已验证链路与后续设计。

AGSwitch 组织配置连接 AIGateway 多模型网关;CloudAgent 已验证 Kubernetes Sandbox、exec与gRPC执行、JuiceFS只读运行时和可写工作区;Go控制面、多租户配额、预热池及E2B接口属于后续设计
Agent 接入与云端执行架构(2026-09-21):AGSwitch 负责组织配置落地,AIGateway 提供模型接入与治理;CloudAgent 底座验证了 Kubernetes Sandbox + JuiceFS 存储分离与远程命令执行。虚线区域为后续业务平台设计,图示不代表性能测试结果。
SRE 服务部署全景:办公网/公网 → APISIX 网关 → ci-01 与 datainfra-01 两个 CCE 集群(32 个服务入口)→ 统一出口 proxy-gateway → 公网;下方为 9 台采集节点 → bot-gateway → BOS → Grafana 的采集链路
全量服务部署图:32 个服务入口、2 个 CCE 集群(ci-01 56 个工作负载 / datainfra-01 31 个)、174 个 IaC 组件。按业务域与环境分组,入口统一走 APISIX,出口统一走 proxy-gateway 三端口,底部是采集链路。图由服务导航 catalog API 的实时数据生成。
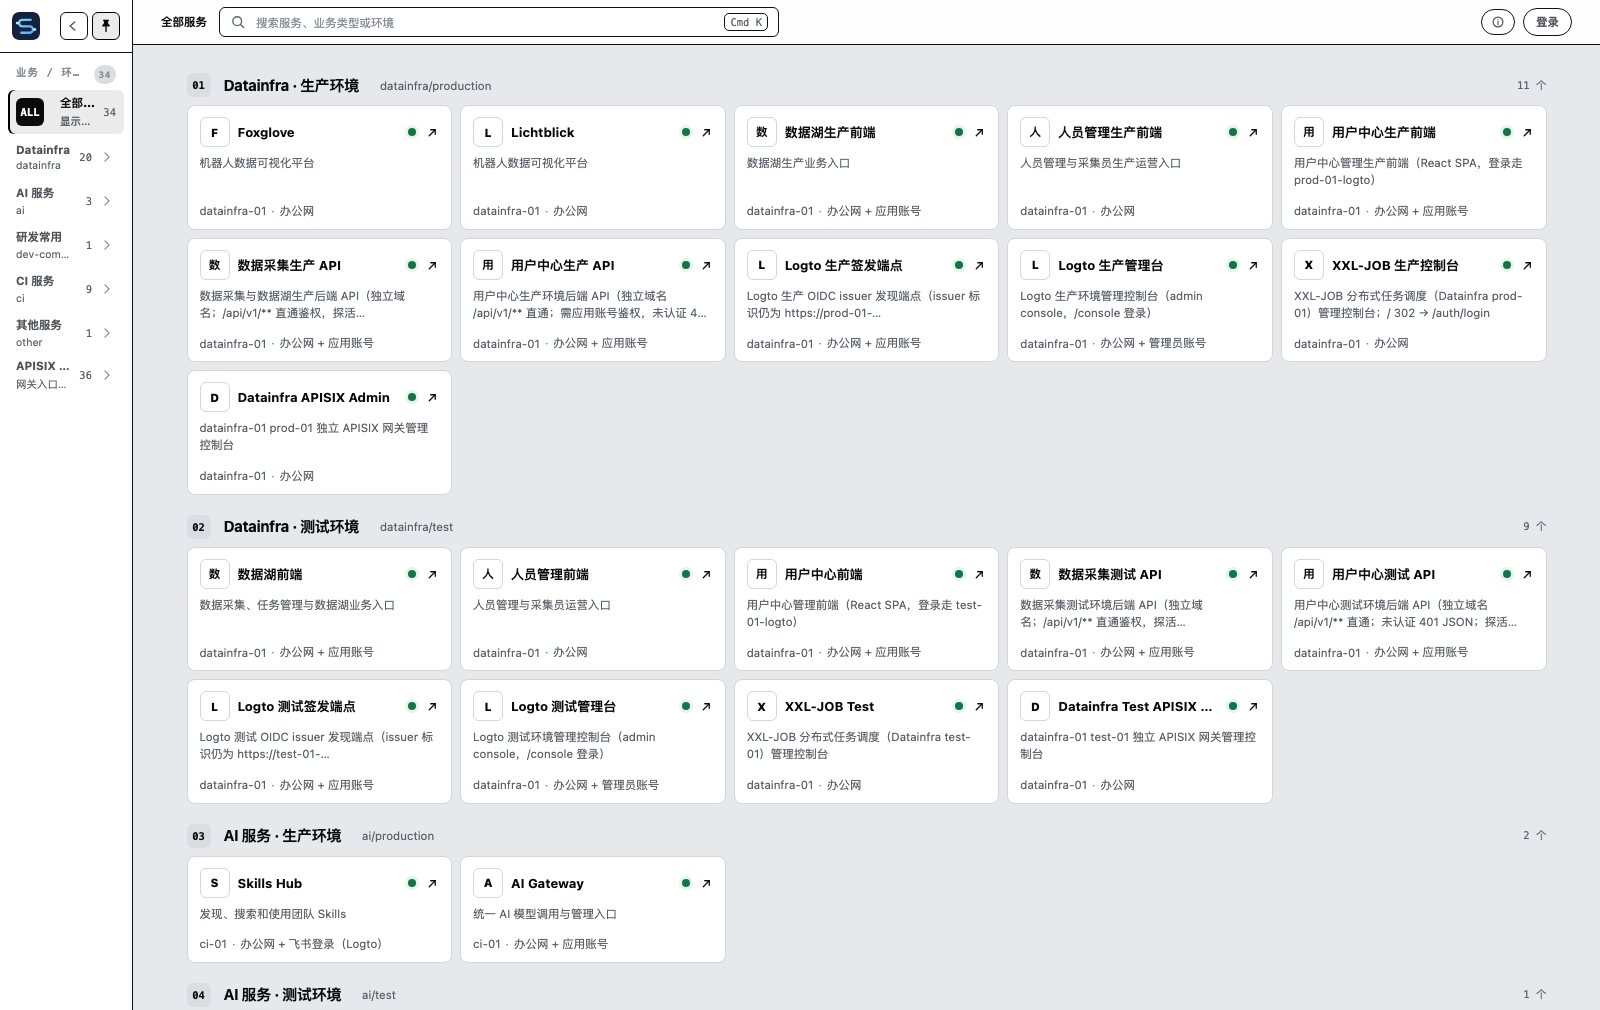
服务导航页面(2026-09-11 实拍):左侧按业务域与环境分组,右侧按分组列出服务卡片,含 Foxglove、Lichtblick、数据湖生产前端、人员管理生产前端、用户中心生产前端、数据采集生产 API、Logto 生产签发端点、XXL-JOB 生产控制台、Skills Hub 与 AI Gateway 等
服务导航(2026-09-11 实拍):把 34 个服务入口按业务域 × 环境编排,每张卡片给出用途、运行集群、访问方式与账号要求;数据以声明式 catalog 为唯一事实源,IaC 与运行期双向对账。页面同时内置统一搜索与 /faq 研发常见问答入口。
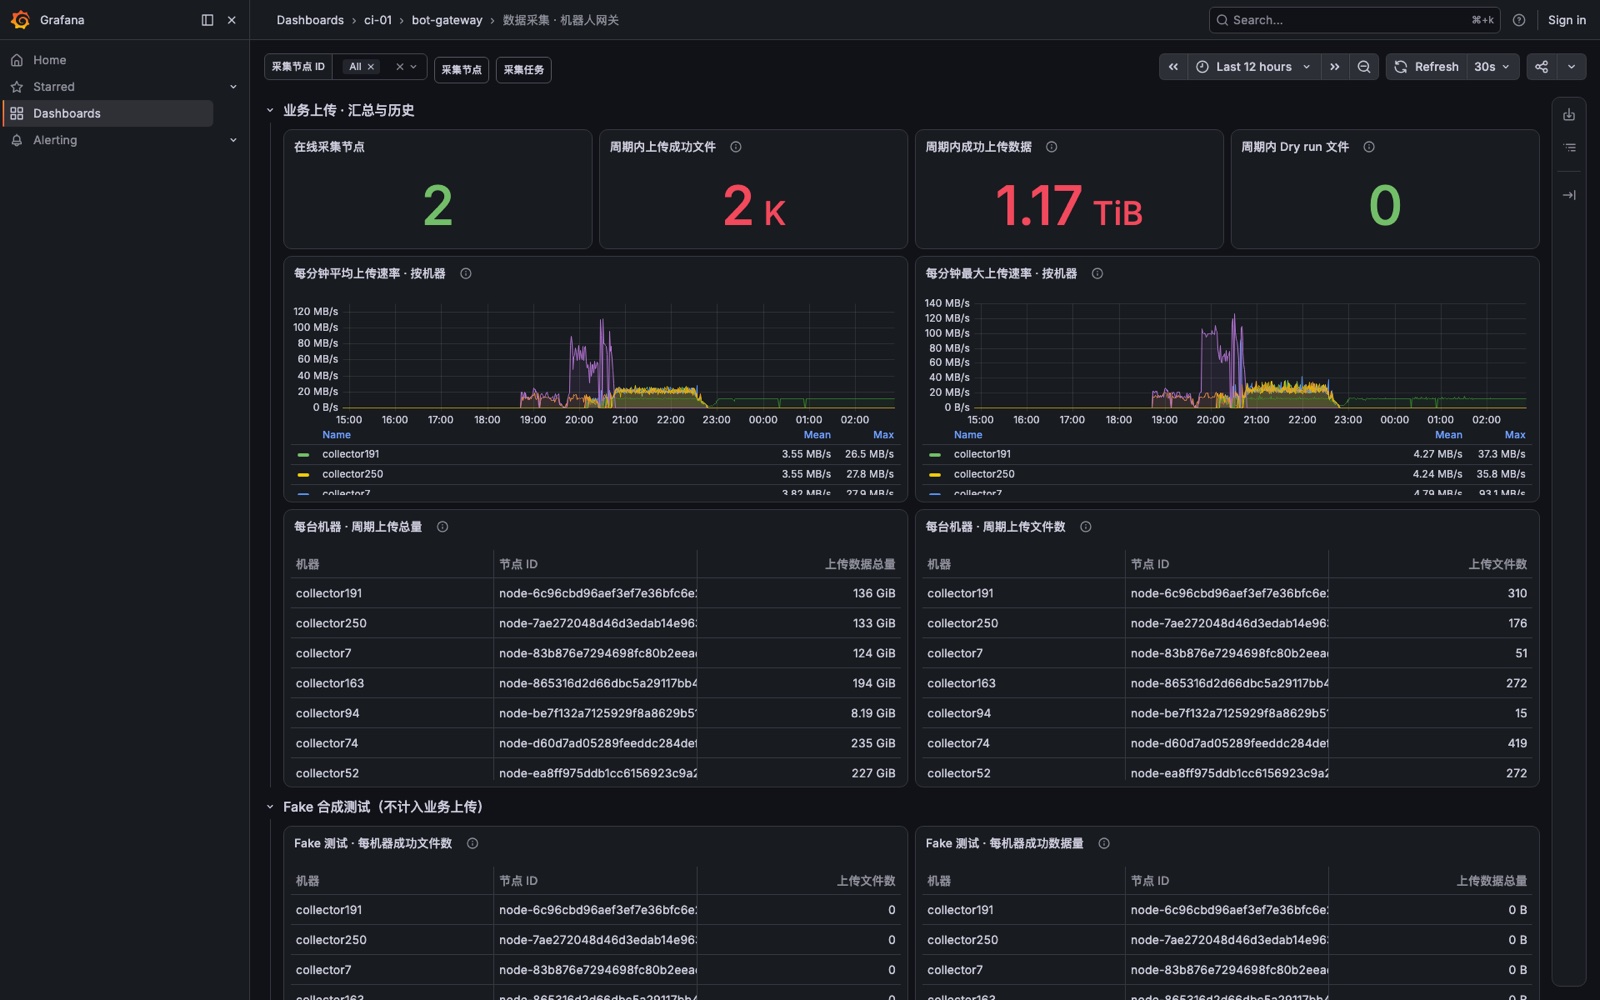
Grafana「数据采集 · 机器人网关」看板:在线采集节点、周期内成功上传文件 2k、成功上传数据 1.17 TiB,以及每台机器的上传速率曲线与上传总量 / 文件数表格
Grafana 监控看板:29 个看板 / 610 个面板之一(数据采集 · 机器人网关)。周期内成功上传 1.17 TiB,每台机器的平均 / 峰值速率、总量与文件数逐台可查;看板由脚本 diff 推送,变更零重启。
机器人网关管理台 · 采集监控窗口统计(2026-09-16 读取,窗口为前一日 00:00–23:59 北京时间):窗口内完成文件 4,119、窗口内完成字节 1.9 TB、窗口平均速率 22.6 MB/s、窗口峰值速率 226.6 MB/s,下方为全天上传速率趋势曲线
采集监控 · 日窗口统计(2026-09-16 读取):单个采集窗口(前一日 00:00–23:59)完成 4,119 个文件 / 1.9 TB mcap 数据上云,平均 22.6 MB/s、峰值 226.6 MB/s,9 台采集节点全天在线;速率趋势逐分钟可回放,上传量按窗口固定口径统计而不是滚动估算。
采集数据自动上传架构图:采集机(9 台,systemd)的业务根目录 → collection-agent(扫描 / 准入 / 路由 / 上传);agent 通过 HTTPS 心跳、任务上报与配置长轮询连到云端控制面 bot-gateway-collection(K8s),并通过 SigV4 直传对象存储 BOS;控制面接 Prometheus → Grafana
数采架构设计:采集机常驻签名 agent,业务文件从物理网卡直连 BOS 不经网关;控制面只下发配置与签名发布清单,Prometheus → Grafana 观测积压与速率。完整设计(准入窗口、读租约、幂等分片、Ed25519 自升级)见飞书《采集数据自动上传 — 架构说明》。
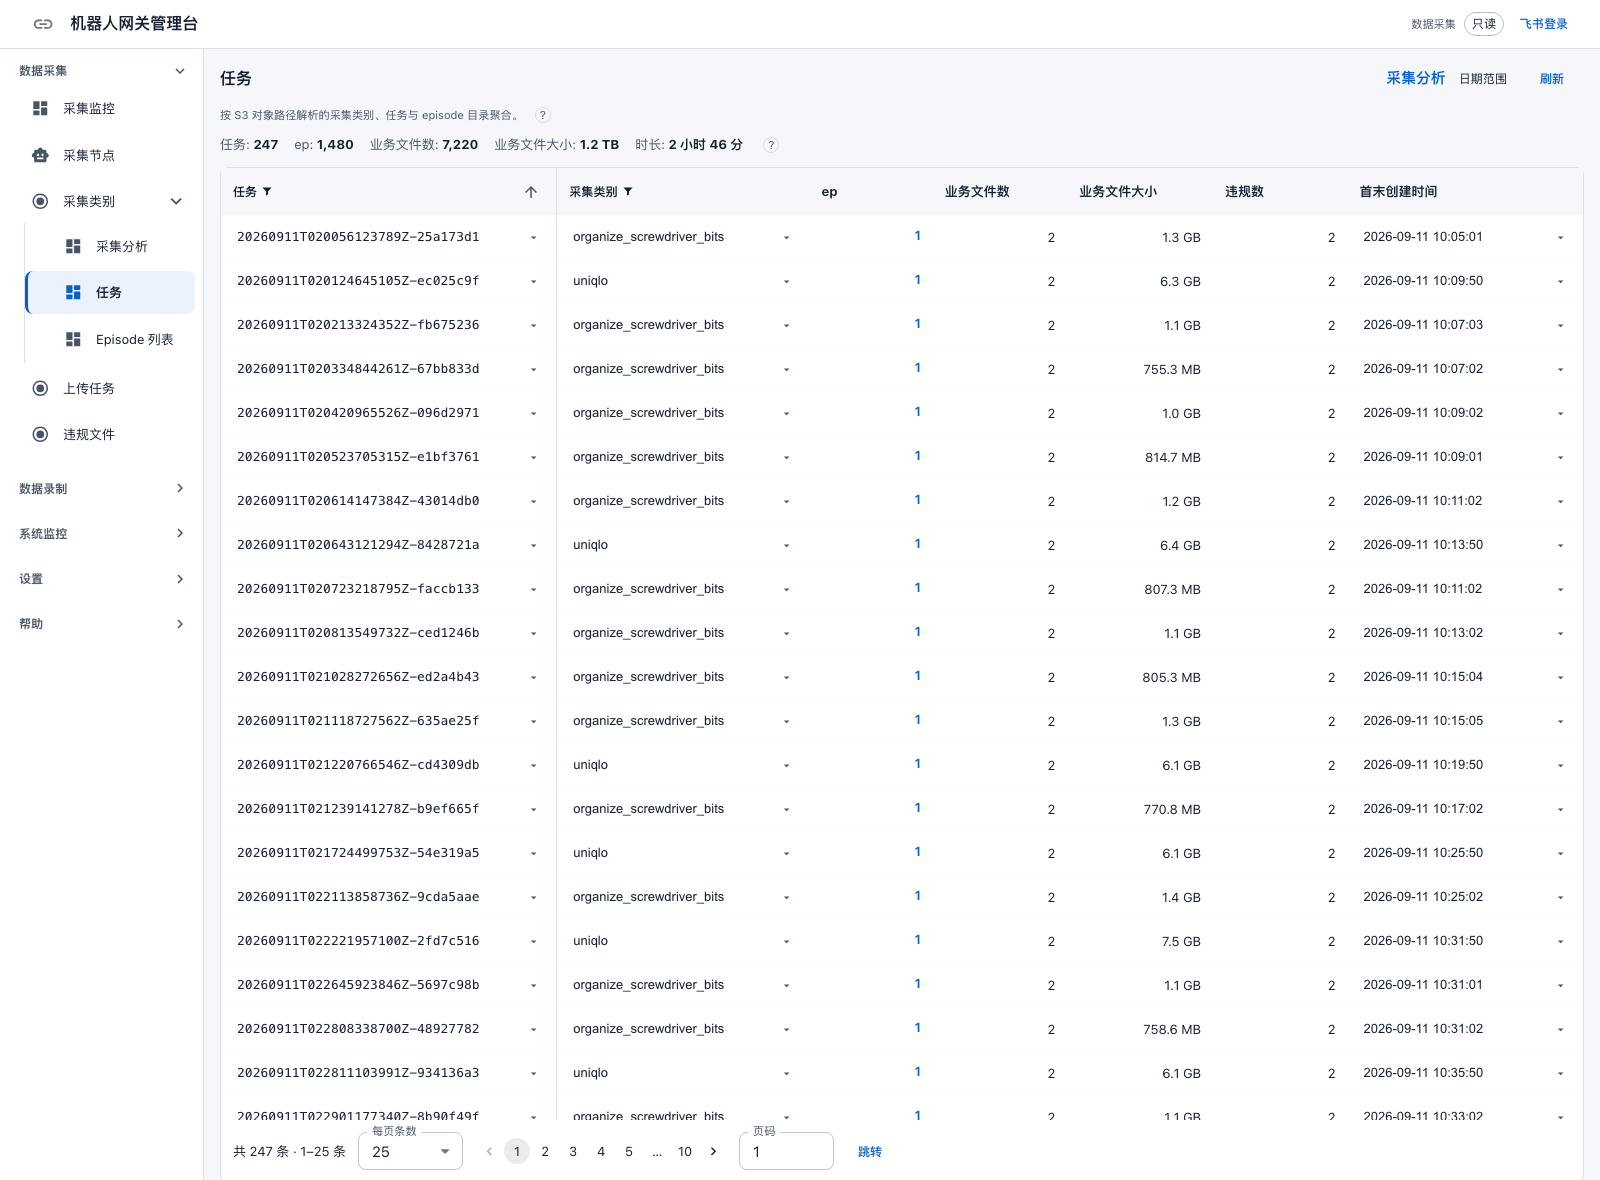
机器人网关管理台 · 数据采集任务页(2026-09-11 实拍):顶部汇总「任务 247 / ep 1,480 / 业务文件数 7,220 / 业务文件大小 1.2 TB / 时长 2 小时 46 分」,下方按对象路径解析出的采集类别逐条列出任务 ID、ep 数、业务文件数、文件大小、违规数与首次创建时间
数据采集任务台(2026-09-11 实拍):采集链路的运营界面,按 53 条对象路径解析出的采集类别聚合任务与 episode 目录。当前 247 个任务 / 1,480 个 ep / 7,220 个业务文件 / 1.2 TB,并逐行给出违规数——不规范数据不会被静默丢弃,而是带着原因计数暴露在运营面上。
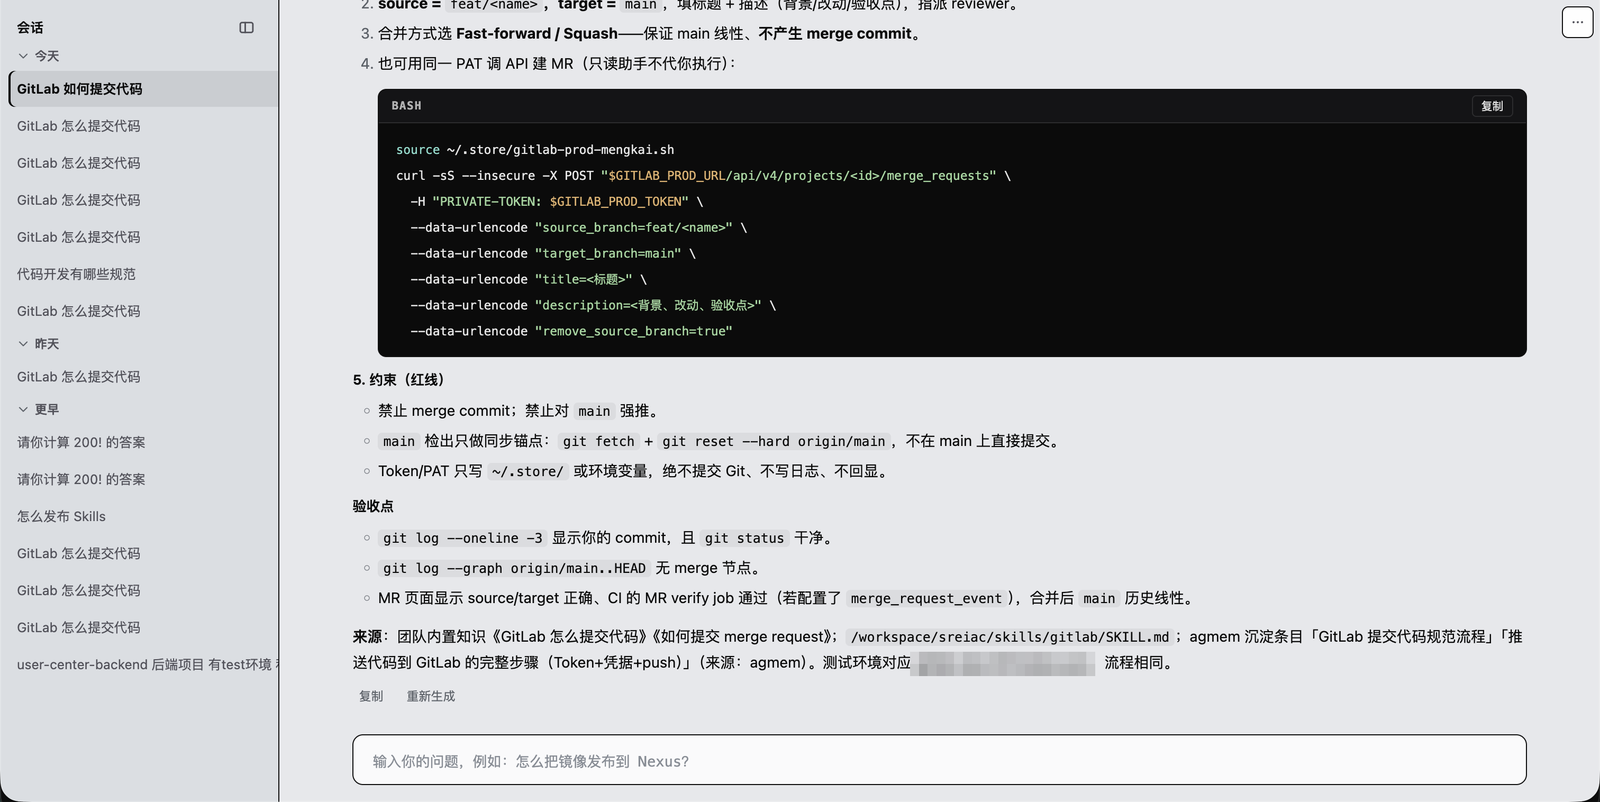
服务导航内置研发 FAQ 助手回答「GitLab 如何提交代码」(2026-09-11 实拍):先是编号的具体步骤与红线约束,再给出 BASH 代码块的可复制命令(source 凭据脚本 + curl 调 API 建 MR,Token 与 URL 全部用环境变量占位),最后是验收点与逐条来源(内置知识、仓库 SKILL.md、agmem 沉淀条目)
研发 FAQ 助手 · 「GitLab 如何提交代码」(2026-09-11 实拍):内部流程类提问(提交代码、发版、配权限、lark-cli 用法等 12 类)命中内置 FAQ 直接作答。答案固定三段——编号步骤 / 可复制命令块 / 验收点,并逐条注明来源;命令里只出现环境变量占位符($GITLAB_PROD_URL、$GITLAB_PROD_TOKEN),凭据本身不进入回答。左侧为问答历史,底部为追问入口。截图已裁掉浏览器界面,并对文中出现的内部域名做打码。
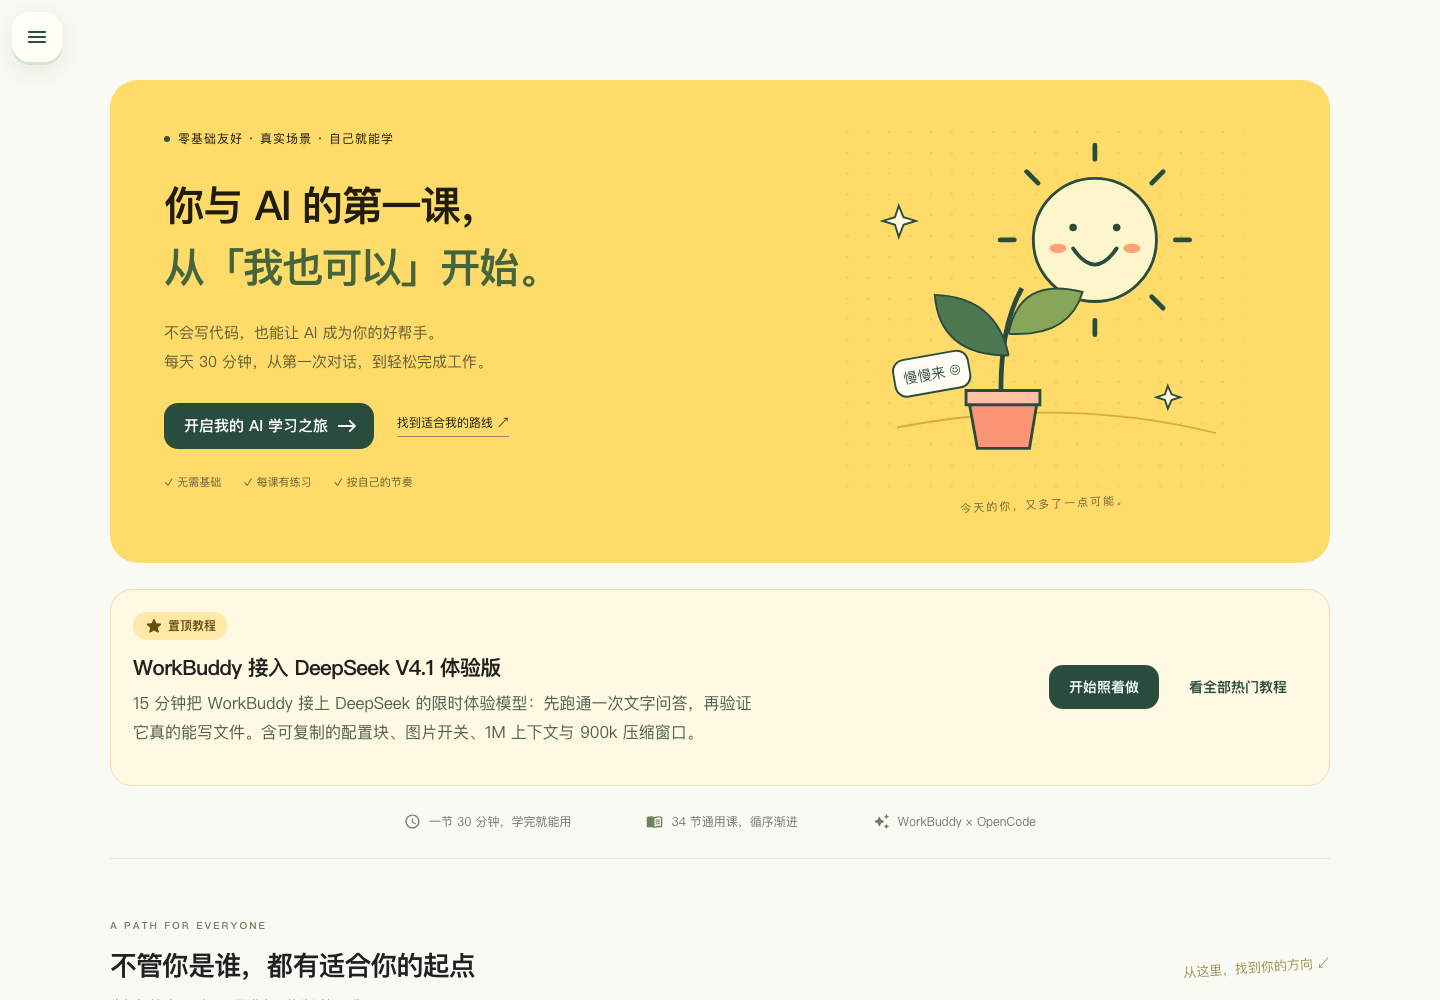
云智 AI 学堂首页:你与 AI 的第一课,从「我也可以」开始;不会写代码也能让 AI 成为好帮手;一节 30 分钟、34 节通用课
云智 AI 学堂 · ai.yzbx.tech:面向零基础用户的免费中文 AI 自助课程,34 节通用课,每个工作日一节、每节 30 分钟。非商业公益项目。
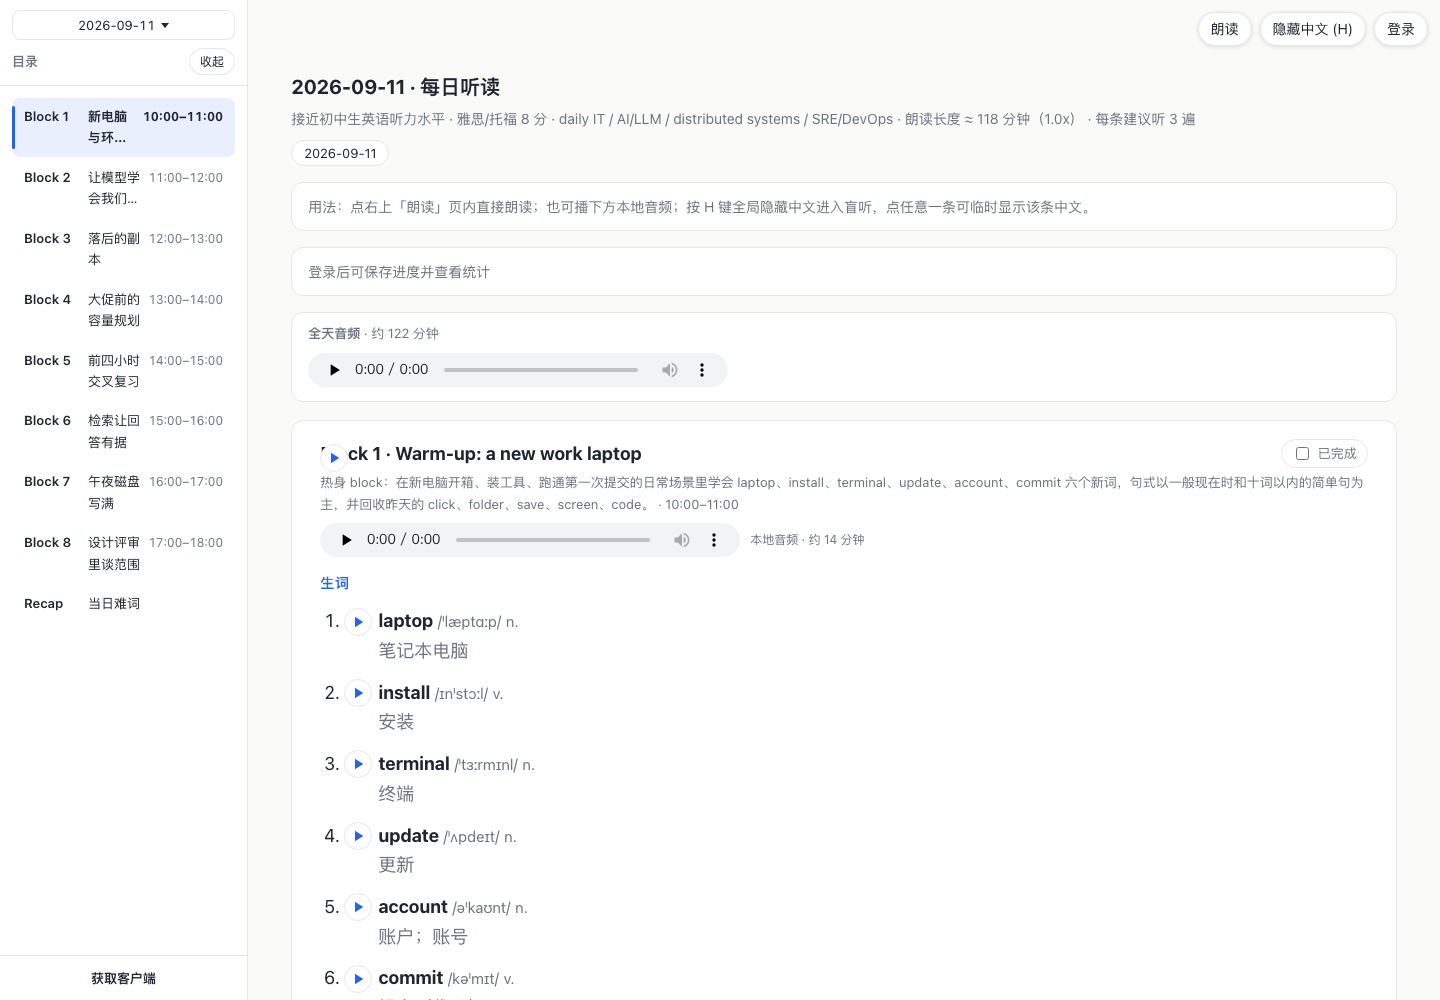
云智英语每日听读页:按 Block 1-8 与 Recap 分段的当日听力课程,含音频播放器、生词表与国际音标、中文释义
云智英语 · eng.yzbx.tech 项目详情 ↗:把每天的英语听读做成可跟读的课程页——按 Block 分段、生词表带 IPA 与中文释义、支持隐藏中文与朗读;主题围绕 IT / AI / 分布式系统 / SRE。

工作经历

从云原生基础设施、分布式构建与存储,到企业级 AI 工程化平台,长期在工程系统的关键路径上做降本增效。

某具身智能企业 2026.08 - 至今 AI 工程化平台 / 效率研发基建负责人

统一构建缓存 · 统一出口 · LLM 网关 · 可观测 · 数据采集

  • 建设统一构建缓存与镜像体系:BuildKit registry 远程缓存跨 daemon 复用,test / prod 部署耗时 80s / 110s(SLA ≤300s),单组件缓存约 381 MiB;工具链版本由 versions.env 单点锁定。
  • 设计三级统一缓存与统一出口:Nexus 作唯一持久制品源,JuiceFS S3 网关压测单文件 716 MB/s、双文件 1.325 GB/s;自研 Go 出口数据面 + nftables 透明拦截 13 条路由,Squid 五入口收敛为三端口。
  • 治理百度云 CCE Kubernetes 1.34 双集群:ci-01 16/16 节点 Ready,VPC 七子网跨四可用区;buildkitd 专用节点 + 300Gi xfs 缓存盘按容量 LRU GC。
  • 自建 LLM 网关(new-api 定制 fork):同一入口暴露 OpenAI Chat / Responses / Anthropic 三协议,统一路由 DeepSeek / 智谱 GLM / 百度千帆,Claude 别名链式映射;百度渠道单日 6,486 请求 / 7.63 亿输入 token。
  • 实现计费与账号治理:billing_mode=tiered_expr 工作日高峰分时计价(DeepSeek 16/16 模型回读生效),Logto OIDC(PKCE S256 + JWKS)与 Passkey 登录;HA 迁移 600 秒探针 513/513 成功、零中断。
  • 定位并修复 LLM 缓存失效:三家上游 × 两协议 × 每组 5 轮对照,去首轮加权命中率百度 24.999% vs zai 99.996% vs DeepSeek 99.675%;网关层 Claude 系统提示词缓存标记频繁变更,导致前缀不能稳定复用;修复后旧客户端由 25% 恢复至 95%。
  • 建设可观测与告警栈(Grafana / Prometheus / Loki / Alloy + 飞书告警)与数据采集平台(9 台节点、每台 10 路并发、幂等分片上传、Ed25519 签名自升级,单日采集窗口完成 1.9 TB mcap 数据)。
轻舟智航 2025.04 - 2026.08 AI Agent DevOps 平台负责人

合规云 · CI / 构建系统 · Agent 调度平台 · 分布式编译

  • 服务奇瑞、吉利、理想等多家头部车企:从零建设合规云与 CI + 构建系统,支撑每天 上千个仿真测试版本 的发布,获甲方高度认可并收到其 offer。
  • 独立搭建 Agent 云平台,接入企业飞书群聊机器人,支持不同群 / 机器人绑定独立 Prompt Template、Skills/MCP、工具权限与任务模板。
  • 设计 Agent Task 编排与调度能力,覆盖 Cron 定时触发、批量化推理、在线交互、异步队列、失败重试、并发限流与容器化沙箱。
  • 研发并调优大规模分布式编译集群,基于负载动态扩缩容与任务路由降低 70% 构建资源消耗;实现 CAS/Worker 分离、按 Mnemonic 路由分组与平滑下线机制。
  • 打通飞书外接 Claude SDK Agent 服务:连通研发业务数据读取与服务调用路径,24 小时高准确率定位疑难研发问题,为 500+ 车企研发大群提供 oncall 支持。
  • Buildfarm 高速分布式编译与测试系统:负责上千节点日常保障与集群研发优化,规模 2 万核 / 40 TB 内存 / 300 TB 存储,构建缓存 95%+ 命中;提升 C++ / Go / JavaScript / Rust 编译效率。架构与测试分片设计 ↗
  • 建设 Skills/MCP 分层管理和插件市场,用户可创建 Task Template 并导入共享配置,降低 Agent 工作流复制、治理和升级成本。
  • 为企业持续提交数百个性能优化、依赖裁剪与工程治理 MR,覆盖构建耗时、镜像体积、运行依赖、CI 稳定性与代码质量门禁。
九维数智(北京)科技有限公司 2024.02 - 2025.04 云原生研发工程师

分布式 CSI 存储 · 快照与 COW · CI/CD · 研发流程治理

  • 为 NFS CSI Driver 增加 快照(VolumeSnapshot)与卷克隆 特性,负责 K8s CSI 驱动与 Operator 二次开发,保障存储层高可用与自动化运维。
  • 参与分布式 CSI 存储链路优化,涉及极速快照、COW(写时复制)与 dentry / dcache 目录遍历路径,降低快照与元数据操作时延。
  • 建设 LDAP 成员管理与 Code Review 服务,完善权限精细化管控和研发流程治理。
  • 构建 CI/CD 平台,整合 Gerrit、Jenkins、BuildKitd、Bazel 与 Harbor,支撑镜像构建、制品发布和流水线门禁。
  • 带领 10+ 人研发团队推进研发流程标准化,提升项目交付效率与平台稳定性。
自由职业 2023.01 - 2024.02 独立开发者

抖音 / 微信小程序开发

  • 独立设计并开发抖音、微信小程序,负责需求分析、前后端开发、上线运营与迭代维护。
华为云计算技术有限公司 2022.03 - 2022.12 分布式构建系统研发

华为云 · 云龙 DevOps · 高性能分布式编译 · Bazel · BuildBarn

  • 参与华为云云龙 DevOps 高性能分布式编译系统研发,服务 昇腾、鸿蒙 两个超大仓库源码构建;构建 CAS 缓存 800T,缓存命中 95%+ 时仍占用 2 万核 CPU / 40 TB 内存,相当于节约 38 万核 CPU / 760 TB 内存。
  • 定位重复文件下载与重复构建问题并增加 fastpath 快速路径,缩短构建时间 70%,助力团队获得总裁嘉奖令。
  • 基于 Bazel、BuildBarn、ccache 落地分布式增量构建缓存,优化 CMake / Maven 等构建链路。
  • 与欧洲团队协作,参与 justbuild 开源项目;绩效优秀,晋升 1 级,获评“最强软件新生”。
武汉泽塔云科技股份有限公司 2021.09 - 2022.03 云计算研发工程师

OpenStack 私有云 · SPICE 虚拟桌面

  • 参与 OpenStack 私有云平台二次开发与运维,支撑私有云基础设施建设、交付和问题排查。
  • 参与 SPICE 虚拟桌面研发,通过 QEMU 逐行 debug 定位内核启动问题,具备内核级问题定位能力(strace、perf、overlayfs 与容器根文件系统构建)。

Pi Agent 源码拆解 · 一条 prompt 怎么走完全程

背景:把自建 LLM 网关接进各家 agent 客户端时,Pi 是唯一一个需要自己写 provider 适配的——配置文件长什么样、「模型什么时候会去调工具」、以及一次最小请求到底发了什么,都只能从源码里读出来才算数。下面用两条真实跑过的命令把链路走通:一条不给工具的 1+1,一条只给 bash 的 100!。文中所有 file:line 对应 @earendil-works/pi-coding-agent 0.85.1(release commit d981de122)。

@earendil-works/pi-coding-agent 0.85.1 · 分层 入口层 · packages/coding-agent/src bin: cli.js(bundle) cli.ts(6 行) main.ts · 选模式 + 组装 interactive / print / rpc 三种模式共用同一套运行时 运行时层 · 会话与 agent 循环 AgentSessionRuntime AgentSession packages/agent · Agent + agent-loop turn 循环 / 流式组装 / 工具调用生命周期 模型层 · 配置与凭据 models.json provider / model / api 适配器 / compat settings.json 默认 provider / model / thinking level(可被 flag 覆盖) ModelRuntime + provider-composer 凭据在发起请求那一刻才解析 不落配置、不进会话记录 协议层 · packages/ai/src/api openai-completions(本页案例) openai-responses anthropic-messages / 其他适配器 工具层(横向) core/tools · 内置工具 read / bash / edit / write extensions · 扩展工具 MCP / 自定义工具 按 allowedToolNames 过滤后 注入到每一轮请求的 tools --no-tools → 空集合 → 全下线 上游 OpenAI 兼容网关 POST <baseUrl>/chat/completions stream: true(SSE) 或各家官方 API 同一套适配器切换 compat 决定协议细节 system / developer 角色 thinking 格式 / 思考回放
图 1 · 0.85.1 的分层架构:入口层只负责解析与选模式,运行时层负责会话与 turn 循环,模型层负责「把 provider 配置变成一次可发的请求」(凭据在这一层才被解析),协议层负责把统一消息翻译成各家 API 的字段。工具层与上游是横向的:工具列表按白名单过滤后注入每一轮请求,而 compat 决定了这次请求在协议上的细节(角色用 system 还是 developer、思考字段怎么发、思考内容怎么回放)。下面两张图分别展开其中的两条路径——一张走完 1+1,一张走完 100!。

复现口径:下面两条命令都在本机真实执行过,命令与输出都是实测,不是示意。

# 场景一:最小请求,一个工具都不给
pi --model ai-gateway/deepseek-flash --thinking off \
   --no-session --no-tools --no-context-files \
   --print '只回答计算结果,不要解释:1+1=?'
# → 2

# 场景二:只给 bash 一个工具,要求精确算出 S = 1! + 2! + … + 100!
pi --model ai-gateway/deepseek-flash \
   --no-session --no-context-files --tools bash --mode json --print \
   '计算 S = 1! + 2! + ... + 100!。必须只调用一次 bash 工具,使用 Node.js BigInt 得到精确整数;工具结果返回后,只给出 S 的十进制值和一句简短说明。'
# → 94269001683709979260859834124473539872070722613982672442938359305624678223479506023400294093599136466986609124347432647622826870038220556442336528920420940313
$ pi --model ai-gateway/deepseek-flash --thinking off --no-session --no-tools --no-context-files --print "1+1=?" shell · argv[2..] 原样交给 main(cli.ts 只有 6 行:setupCli() → main(process.argv.slice(2))) args.ts · 手写解析,无第三方库 print=true · noTools=true · noSession=true noContextFiles=true · thinking="off" messages=["1+1=?"](--model 此处只存字符串,不解析) main.ts · 选模式 + 组装服务 resolveAppMode → "print"(print 为真即命中) takeOverStdout():把 stdout 让给结果,日志走 stderr Settings → SessionManager(内存) → 模型解析 → Agent 两个开关真正关掉了什么 --no-tools → allowedToolNames=[] → 工具表过滤成空 Agent 拿到的 tools 为空,系统提示词里的工具段落也一并消失 --no-context-files → 不再发现 AGENTS.md / CLAUDE.md model-runtime + provider-composer 读 ~/.pi/agent/models.json 里的自定义 provider 凭据在发起请求时才解析,不落配置、不进会话记录 authHeader=true → 加上 Authorization: Bearer openai-completions.ts · 拼请求 convertMessages 先过 transformMessages,再拼系统消息 stream: true · stream_options:{include_usage:true} tools 为空时 整个键省略,不是 tools: [] POST <baseUrl>/chat/completions → SSE 流回来后 print-mode 取 state.messages 的最后一条 只要 role=assistant 且 stopReason 不是 error/aborted, 就把每个 text 块写到 stdout;thinking 与工具块直接丢弃
图 2 · 一次 1+1 的完整链路:从 shell 的 argv 到上游的一次 POST,再到 stdout 上的那一个字符。注意两个容易反直觉的点——工具为空时请求体里连 tools 键都没有(不是空数组),而凭据是在发请求那一刻才解析的,不落任何配置文件。
flag解析出的字段实际效果源码位置
--print / -pprint = true配合 resolveAppMode 选中 print 模式;非交互、跑完就退args.ts:157 · main.ts 模式判定
--no-tools / -ntnoTools = true转成 noTools:"all" → allowedToolNames = [] → 工具表过滤成空 Map,系统提示词里的工具段落一起消失args.ts:133 · main.ts · sdk.ts:258
--no-context-files / -ncnoContextFiles = true不再从 cwd 逐级向上发现 AGENTS.md / CLAUDE.md,也不加载全局上下文文件args.ts:194 · resource-loader.ts
--no-sessionnoSession = true会话不落盘,用内存态 SessionManager;跑完即弃args.ts:121 · main.ts
--thinking offthinking = "off"取值先按白名单校验。agent 层把 off 映射成 reasoning: undefined;但「请求体里怎么表达关掉思考」由 thinkingFormat 决定——deepseek 格式会显式发 thinking:{type:"disabled"},OpenAI 通用分支则看 thinkingLevelMap.off 是否要发 reasoning_effortargs.ts:147 · agent.ts:450 · openai-completions.ts:914 / :957
--modelmodel = "ai-gateway/deepseek-flash"解析阶段只存字符串;provider/model 的拆分发生在模型解析器里args.ts:106 · model-resolver.ts
结尾的位置参数messages = ["1+1=?"]第一个被 shift() 出来当 initialMessage,所以 print 模式只发了一次 promptargs.ts:157 · initial-message.ts

顺带一个反直觉的点:--no-tools 并不只是「停用 read/bash/edit/write」。它给出的是一个空的白名单集合,工具注册表按 allowedToolNames.has(name) 逐项过滤,空集合对谁都返回 false,于是扩展工具与自定义工具也一并下线——最后连给模型看的工具列表都是空的。

为什么第一次请求是 HTTP 400:系统提示词的角色

把网关接进来之后,最小请求第一次返回的是 HTTP 400:网关明确拒收 role: "developer",只接受 system。根因就在下面这三行——系统提示词用哪个角色,是两个条件同时成立才走 developer:

// packages/ai/src/api/openai-completions.ts
const useDeveloperRole = model.reasoning && compat.supportsDeveloperRole;
const role = useDeveloperRole ? "developer" : "system";
params.push({ role: role, content: sanitizeSurrogates(context.systemPrompt) });

model.reasoning 是模型的静态能力,不是本轮开关

它是 Model 接口上的一个 boolean(types.ts:849),在 models.json 里按模型声明,表示「这个模型支持思考」。它和 --thinking off 不是一回事——后者只影响本轮带不带思考参数。所以即使加了 --thinking off,只要模型被声明为 reasoning,这个条件依然成立。

supportsDeveloperRole 会被自动探测

没显式声明时,getCompat 用探测值兜底:isOpenRouterDeveloperRoleModel || (!isNonStandard && !isOpenRouter)(openai-completions.ts:1634)。一个普通自建网关两边都不沾,于是探测成 true。两个条件都为真 → 角色被写成 developer → 网关 400。

修法:在 models.json 的 compat 里显式写 supportsDeveloperRole: false。显式值优先于探测值(getCompat 逐字段 ?? 兜底),角色随即回到 system。

同一个坑还有两个 DeepSeek 专属兼容开关:thinkingFormat: "deepseek" 与 requiresReasoningContentOnAssistantMessages 的自动探测条件,是 provider 名等于 deepseek 或 baseUrl 含 deepseek.com。网关域名显然不满足,所以这两项也必须显式声明,否则多轮会话里 reasoning_content 的回放约定对不上。

场景二:100! 为什么会去调 bash

先纠正一个常见误解:--tools bash 不是「让模型调用 bash」的指令,它只是一份白名单——注册表按它过滤,过滤完只剩 bash 一个工具可选。选不选、选几次,仍然由模型自己决定。真正让模型倾向于调用工具的,是它看到的工具描述:

// packages/coding-agent/src/core/tools/bash.ts:235
Execute a bash command in the current working directory. Returns stdout and stderr.
Output is truncated to last 2000 lines or 50KB (whichever is hit first).
If truncated, full output is saved to a temp file. Optionally provide a timeout in seconds.

// 参数 schema(bash.ts:38)
{ command: string,  timeout?: number }   // timeout 单位是秒,无默认超时

「能执行 shell、会返回 stdout」这一句话就足够模型判断:与其自己把 100 次阶乘一位一位算出来,不如起一个 node -e 用 BigInt 算完再把结果读回来。于是它发出的是一个 toolCall 内容块,而不是文本。

事件名取自 agent-loop.ts 的 emit(),右侧括号是发出它的位置 agent_start → turn_start(进循环之前各发一次) 第 1 轮 · streamAssistantResponse() assistant 消息(流式拼出来) · thinking 块:该用 BigInt 精确算,写个循环 · toolCall(name="bash") —— 唯一的内容块 stopReason = "toolUse"(不是 length,参数完整) executeToolCalls() tool_execution_start → bash 起 shell → tool_execution_end stdout 包成 toolResult 消息:role="toolResult" 塞回 currentContext.messages ← 这是模型下一轮能看到它的原因 hasMoreToolCalls = true → 再来一轮 第 2 轮 · 先发 turn_start,再 streamAssistantResponse() assistant 消息 · 只有一个 text 块:S 的十进制值与一句说明 · 没有 toolCall,thinking 也不再出现 stopReason = "stop" 循环怎么收尾 toolCalls.length == 0 → hasMoreToolCalls = false → turn_end → 内层 while 条件为假 → 无后续消息 → break 最后一行才发 agent_end agent_end · 循环一共跑了 2 轮,模型自己决定只调了 1 次工具 两类提前退出:stopReason 为 error / aborted 直接 turn_end + agent_end;工具批返回 terminate 则停止继续执行工具。
图 3 · 一次工具调用的两轮循环:模型在第 1 轮发出工具调用,工具结果被包成一条 role: "toolResult" 的消息塞回上下文——这就是模型下一轮能「看见」结果的原因。第 2 轮没有工具调用,循环条件不再成立,才走到 agent_end。
#事件这一时刻发生了什么
1–2agent_start → turn_start进循环之前各发一次,不在 while 里
3assistant 消息(流式)内容 = thinking 块 + 一个 toolCall(name:"bash");stopReason = "toolUse"
4–6tool_execution_start → 执行 → tool_execution_end起 shell、跑命令、收集 stdout,并带上 isError 标记
7toolResult 消息role:"toolResult",带 toolCallId / toolName / content,被 push 进上下文
8turn_end(带 toolResults)本轮结束;hasMoreToolCalls 仍为真,于是回到循环顶部
9turn_start(第 2 次)这一轮的 turn_start 发在 while 内部、流式请求之前
10–11assistant 消息 → turn_end只有文本块、没有工具调用,toolCalls.length == 0 → hasMoreToolCalls = false
12agent_end内层 while 条件为假、也没有排队的后续消息,跳出外层循环后发出

循环的终止条件(三类)

① 正常收敛:某轮 assistant 消息里没有工具调用,内层 while 的两个条件同时为假,外层也拿不到后续消息,break 后发 agent_end。

② 出错中断:stopReason 为 error 或 aborted 时,直接 turn_end + agent_end 返回,不执行任何工具。

③ 主动叫停:工具批返回 terminate,或 shouldStopAfterTurn 钩子返回真,都会提前结束。

一个容易被忽略的边界:stopReason === "length"

如果输出是被 token 上限截断的(stopReason = "length"),消息里的工具调用参数可能是不完整的。这时 pi 不会去执行它们,而是统一判失败——「宁可这一步失败,也不要拿半截参数去跑一条 shell 命令」。

这个判据写在工具调用分发之前,属于比较典型的一处防御性设计。

观测手段与边界:--mode json 会把会话事件按行输出(message_update 会去掉累积快照,只留增量与 usage),足够复现整段对话;但 pi 没有「打印原始 HTTP 请求体」这样的开关——全仓搜不到 DEBUG / TRACE / VERBOSE 类的调试环境变量。要逐字节核对 body,有两条路:① 读 buildParams / convertMessages 从源码推导,本文的字段级结论就是这么来的,属于源码重建而非抓包实录;② 它有代理支持——代码用的是 undici 的 EnvHttpProxyAgent(core/http-dispatcher.ts:87),HTTPS_PROXY / NO_PROXY 都会被读取,把 HTTPS_PROXY 指到一个本地抓包代理即可看到真实请求(这条是读代码得出的可行路径,本页未实测)。

agmem 分层记忆检索 · 分层知识、定时录入与固定请求头

以下保留 2026-09-09 的早期分层设计记录。当前源码中的本地版本校验、ONNX 相似度比较、云端缓存分支及知识新增更新流程,见agmem 最新架构图与实现说明;问答侧集成见研发 FAQ 助手详情。

一、分层知识设计:越靠前命中,外部调用越少

提问 → 逐层向下,命中即返回 ① 问答服务进程内预检索缓存 内置 FAQ 与高频问题命中即 0ms 返回,连检索都不发起 ② agmemserv 进程内查询缓存(Pod PVC 上的 SQLite) 精确命中直接跳过 embedding 调用——省掉的是最贵的那一步 ③ agmemd 用户侧本地守护 同一套 SQLite 缓存实现,本地 768 维向量先做相似度 ④ 共享索引 · Qdrant + MySQL 前三层都没命中才走这里:全量向量检索 + 云端兜底 外部调用:0 次 纯进程内,最短路径 embedding:0 次 按 (dir, question) 精确匹配 仅本地向量计算 不出本机、不走网络 全量检索 + 云端兜底 最慢的一层,只在必要时到达 版本门控:本地条目都带一个 kb 版本号 任何知识生命周期的变更都会 bump 版本——版本对不上,②③ 两层本地缓存整体失效,避免多实例读到陈旧知识。 实测:云端路径约 1.4s → 缓存命中 0.09s。
图 · 分层知识检索:四层的分界不是「存哪儿」,而是命中一次要花掉多少外部调用——① ② 都是 0 次,③ 只算本地向量,只有 ④ 才真的落到 Qdrant 与云端。版本门控保证 ② ③ 两层本地副本不会在多实例之间读飘。

四层的实现口径

① 问答服务进程内预检索缓存:内置 FAQ 与高频问题命中即返回,连检索都不发起。
② agmemserv 进程内查询缓存:落在 Pod 的 PVC 上,精确命中直接跳过 embedding 调用。
③ agmemd 用户侧本地守护:与 ② 共用同一套 SQLite 缓存实现(同一个 500 MB LRU 默认口径),本地先算 768 维向量相似度。
④ 共享索引 Qdrant + MySQL:前三层都没命中才走全量向量检索与云端兜底。

「分层」落到代码上是什么

本地缓存条目里带一个 KBVersion 字段。知识生命周期的任何变更都会 bump 版本,条目版本与当前 kb 版本对不上即视为失效——这样多实例部署下不会有人捧着旧知识作答。

效果是可测的:同一路径云端约 1.4s,缓存命中 0.09s(验收口径见 todo/agmem-plan-v3.md A3:规格 <2s / <100ms)。

二、知识定时提取录入设计:不是 CronJob,是进程内的一个槽位调度器

飞书 SRE 知识库全树的增量同步,不是 Kubernetes CronJob——它跑在 agmemserv 进程里(go syncer.Run(ctx)),由一个 1 分钟粒度的 ticker 驱动,真正决定「这一分钟要不要干活」的是30 分钟槽位:槽位 key 必须与上次执行的槽位不同,因此每个 :00 / :30 至多跑一次。

设计点取值为什么这么定
调度载体进程内 goroutine + 1 分钟 ticker不引入 CronJob:调度与知识服务同生命周期,避免两处配置漂移
执行节流SlotInterval = 30 分钟,槽位 key 去重ticker 只是「心跳」,槽位才是「节拍」——不会因为重启而多跑一轮
允许时段0-8,12-13,18-23(Asia/Shanghai)避开 9-12 与 14-18:这两段是 deepseek-flash 的调用高峰,知识提取主动避峰
增量判据只处理 obj_edit_time 变大的文档未变更的文档零外部调用跳过:不取正文、不入队、不删除
单轮边界20 分钟超时 + 重入保护上一轮没跑完就跳过这一轮,不叠加
失败语义遍历整棵树失败 → 本轮不改动任何数据避免「扫描失败」被误读成「文档被删除」而误删知识
重试条目级指数退避,基数 30s、最多 3 次失败条目回 pending 重新排队,不拖累其他条目

写入管线:抓取正文 → 入队(wiki 全树用不去重入队;人工推送按原文去重)→ worker 取任务、嵌入原文(1024 维)→ 清洗 → 切成 ≤600 字条目 → 批量嵌入 → 以确定性 UUID upsert 成 clean 点 → BumpVersion。确定性 id 让重复执行天然幂等,重跑不会产生重复知识。

三、录入知识固定请求头:机器对机器,就不引入每请求签名

录入链路上的身份是一个固定的机器凭据,不是每次请求现算的签名或临时令牌。这带来一个很实际的好处:写入与检索共用同一条受控通道,排障时「这条知识是谁写进来的」只有一个答案。

录入接口:Authorization: Bearer <机器 token>

值来自进程启动时读一次的环境变量,之后固定在客户端结构里,不按请求派生。所有录入入口用的是同一个 token——命令行 agmem push、MCP 工具 agmem_push、批量导入脚本、端到端用例,四处逐一核对过。

服务端比对时用常数时间比较的是 token 的 sha256,且只认字面量前缀 Bearer 。

落库侧:每条 Qdrant 请求都带同名 api-key

写入(upsert)与检索(search)走的是同一个 transport,请求头在同一处统一附加;值来自单独一份配置,启动时读一次。

仓库里还有一个专门的测试 TestAllRequestsCarryAPIKey,断言「建集合 / 写入 / 检索」这几类请求携带的是同一个 key 值——把「固定头」这件事当成契约钉住了。

边界说明(避免误读):这条「固定头」只描述 agmem 的录入链路。调度侧访问飞书开放平台用的是会过期的 tenant_access_token,那是动态头,和这里的固定凭据不是一回事;两者不要混着讲。

Codex 开发流程优化

本机快照(2026-09-23,Codex CLI 0.156.0)。开发流程按“目标与验收 → 任务拆分与分工 → 实施 → 独立复核 → 发布回读”组织;下列模型、上下文、压缩和子代理设置是流程优化的配置实践,不代表量化提效结果或 Codex 产品默认值。

模型与上下文

默认模型为 gpt-6-sol / medium。配置窗口为 872,000 tokens;模型目录按 95% 有效比例折算为 828,400 tokens。

自动压缩

在有效窗口的 90%(745,560 tokens)开始压缩,低于 828,400 的有效上限,并保留 82,840 tokens 余量。

子代理容量

48 GiB 主机按每 2 GiB 一个并发名额设为 24 个子代理线程(主线程不计);默认子代理为 gpt-6-luna / high。这是容量预算,不表示每个线程独占 2 GiB 内存。

桌面用量显示

已开启 show-context-window-usage;是否显示仍取决于运行时是否提供窗口和 token 用量数据。

AI 消耗统计

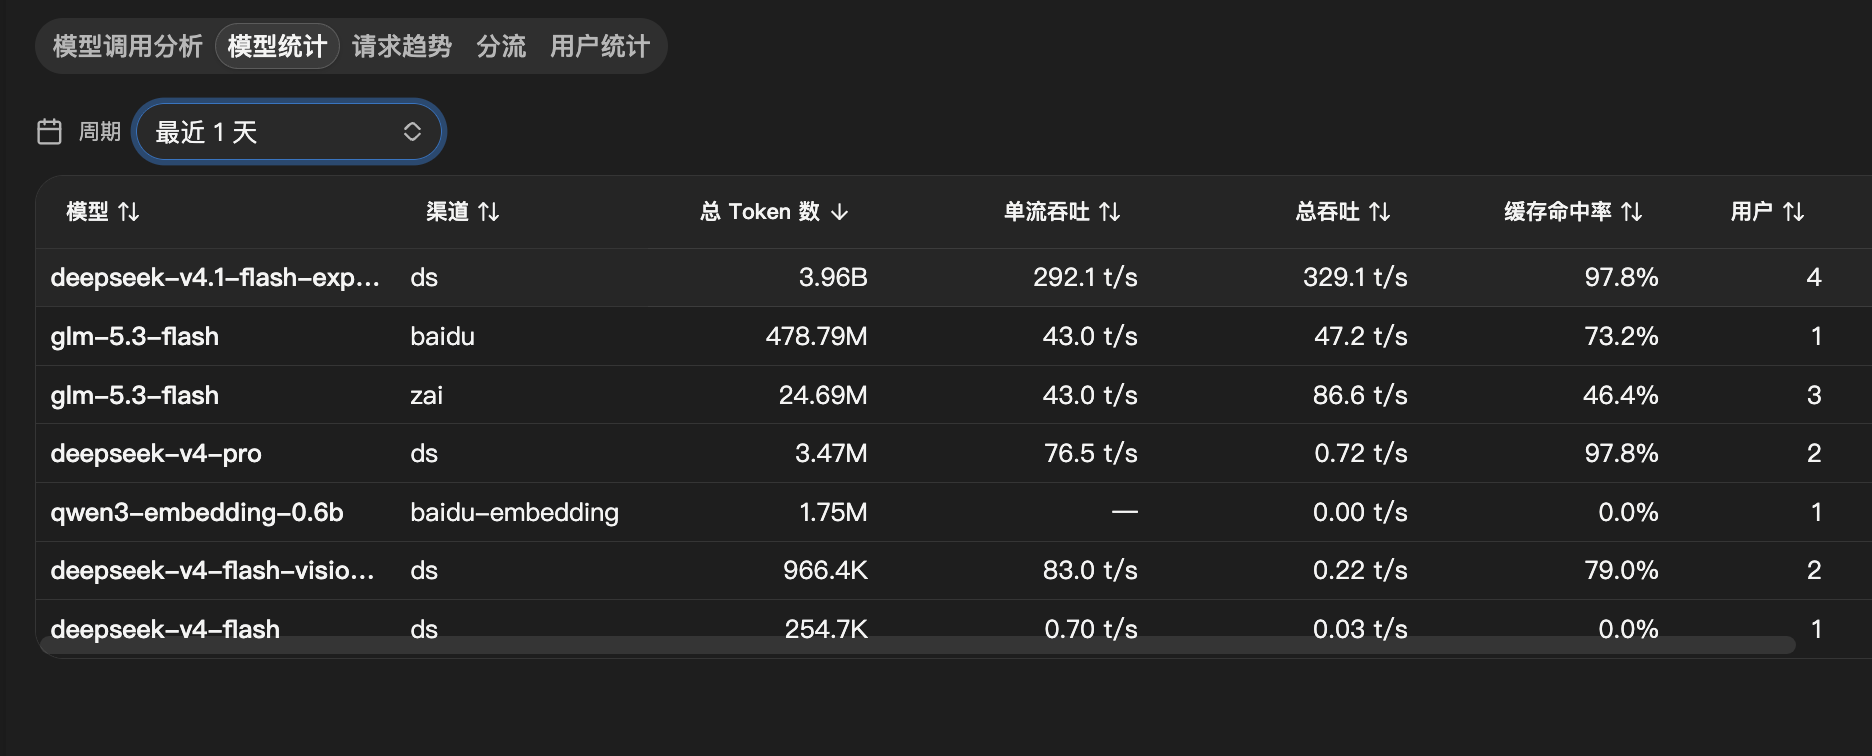
自建 LLM 网关 new-api「模型统计」历史读数(2026-09-10,本人日常开发场景)。当时最近 1 天 5 个(渠道、模型)组合合计 ≈5.70B token,其中单模型 deepseek-v4.1-flash-exp 5.64B、总吞吐 596.7 t/s、缓存命中 98.3%。以上仅为网关可监控口径。

5.64B单日单模型 Token(deepseek-v4.1-flash-exp)
≈5.70B单日 5 行合计(最近 1 天,网关可监控口径)
596.7 t/s单日总吞吐峰值
98.3%单日主力模型缓存命中率
new-api 模型统计页面,周期最近 1 天:deepseek-v4.1-flash-exp 5.64B token、单流平均 195.5 t/s、单流最大 513.5 t/s、总吞吐 596.7 t/s、缓存命中率 98.3%;glm-5.3-flash(zai)38.31M;glm-5.3-flash(baidu)21.35M;qwen3-embedding-0.6b 1.05M;deepseek-v4-flash 262.2K
周期 1d(09-10 读数):deepseek-v4.1-flash-exp 5.64B token(单流平均 195.5 t/s、单流最大 513.5 t/s、总吞吐 596.7 t/s、缓存命中 98.3%);glm-5.3-flash(zai)38.31M(80.2%);glm-5.3-flash(baidu)21.35M(70.3%);qwen3-embedding-0.6b 1.05M;deepseek-v4-flash 262.2K;5 行合计约 5.70B token。

口径说明:以上仅为自建网关可监控到的部分——另有多套未接入网关监控的 Codex 账户同时在用,实际消耗高于该数。缓存命中率的渠道差异在同一次读数里就看得见:本次单日百度渠道 glm-5.3-flash 70.3%,DeepSeek 主力模型 98.3%,这也正是 疑难问题定位 那一节做逐渠道加权比对、并定位到动态预算提醒与尾部缓存断点的起点。

消耗构成:这些 token 落在同期的平台建设上——数据采集平台、机器人 GPU 节点接入、Grafana 集群(几百个监控面板、上千条监控趋势)、APISIX 网关与流量监控、鉴权缓存与请求链路优化。日常研发、排障、代码阅读与文档工作全部由 Agent 客户端承载,这也是我自建网关、并把缓存命中率当成一等指标来盯的原因。

公益项目 · 非商业

云智 AI 学堂:让每个人,都能用好 AI 项目详情 ↗

面向零基础用户的免费中文 AI 自助课程——不会写代码也能上手,每天 30 分钟,从第一次对话到完成真实工作。34 节通用课,覆盖学生、文员、财务与行政场景;目标是让 AI 的门槛低到「我也可以」。

访问 ai.yzbx.tech →
云智 AI 学堂首页:你与 AI 的第一课,从「我也可以」开始;零基础友好、每天 30 分钟、34 节通用课